
dsh-web
zhu1090093659/dsh-webDeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)

通过 1session 命令行或 DSH Web 历史浏览器搜索和读取 Claude Code、Codex、Antigravity、Grok 与 DSH 的本地编程会话。
在 DSH Web 中查看跨智能体历史,也可作为独立 1session CLI 与 TypeScript 库使用。
支持 Claude Code、Codex、Antigravity、Grok 和 DeepSeek Harness:发现会话、搜索原文、逐轮查看,并按工作目录聚合。Read Plane(读平面)以本地原始会话文件为唯一准绳,不修改原始会话;本地 SQLite 索引用于加速检索,可从源文件重建。只读浏览不依赖 ACP 服务或常驻守护进程。
要求 Node.js >= 22.15,并已安装 DeepSeek Harness。在终端运行:
dsh plugin --profile web add @1agents/session-reader
dsh web
包内的 dsh.bundle.patch 会在安装时启用插件。已经运行 DSH Web 时,安装或升级后重启服务,再打开侧栏「历史会话」。从 DSH 源码仓库运行时,在以上命令前加 pnpm;使用其他 profile 时将 web 替换为对应名称。
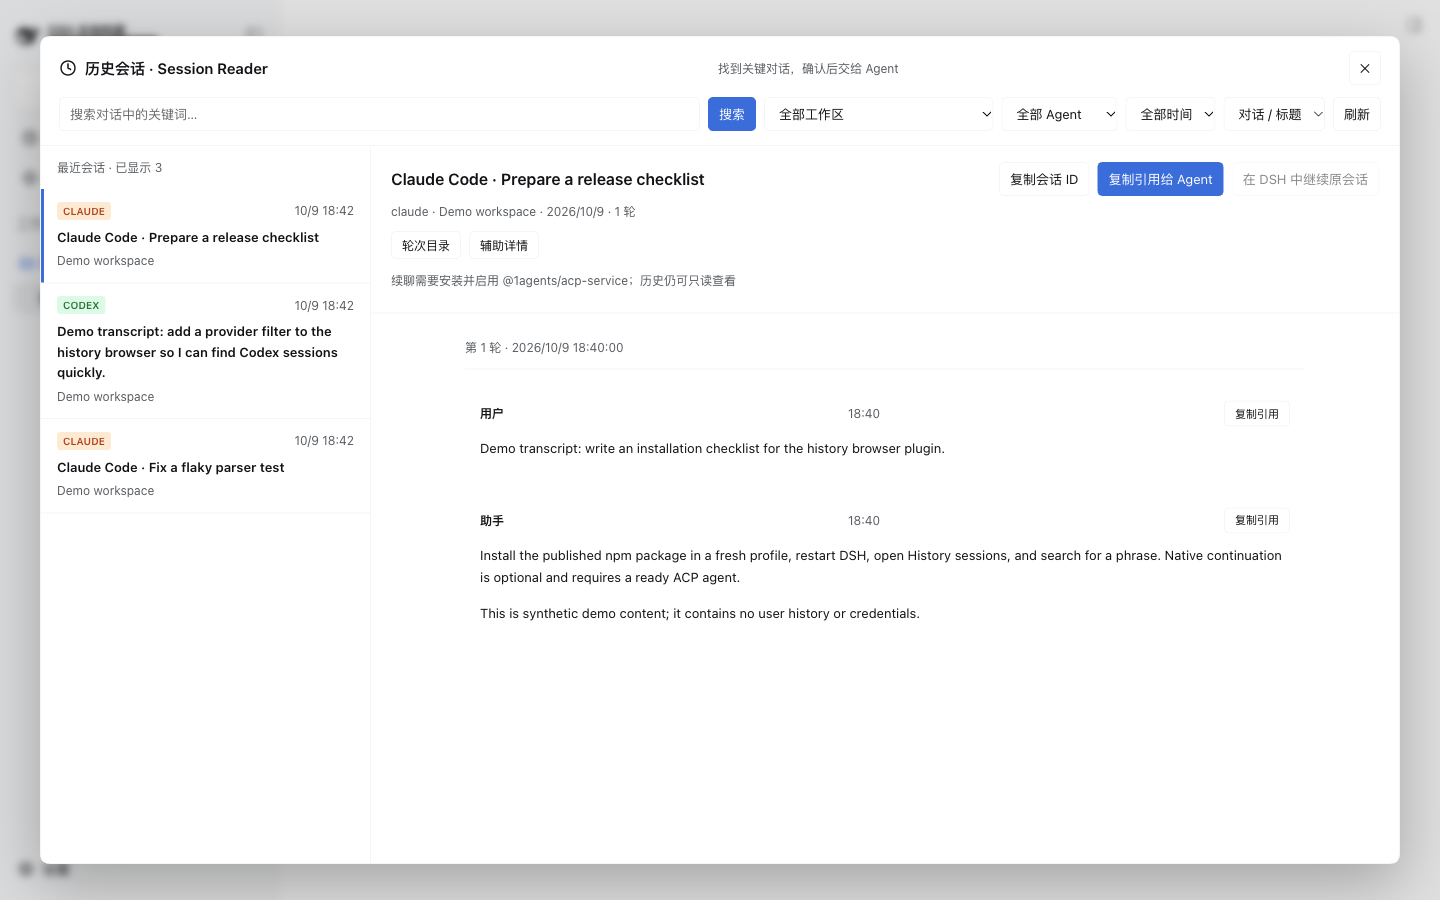
截图使用独立测试 profile 中的合成示例会话。拍摄环境与验证范围。
五种来源均可只读浏览。要在 DSH 中继续 Claude、Codex、Grok 的原生会话,还需安装可选的 @1agents/acp-service,配置对应 Agent 的 CLI 与登录状态,并保留原工作目录;DSH 来源打开原 DSH 会话,Antigravity 目前仅供浏览。详细条件见在 DSH 中继续原会话。
| Provider | 落盘位置 | 工作区来源 |
|---|---|---|
antigravity | ~/.gemini/antigravity/brain/<uuid>/.system_generated/logs/transcript.jsonl(+ 同级 implementation_plan.md / walkthrough.md 等产出物) | run_command 的 Cwd;缺失时由所操作文件向上找 .git |
claude | ~/.claude/projects/<slug>/<session-id>.jsonl | 条目自带的 cwd 字段(目录 slug 只用作快速预筛) |
codex | ~/.codex/sessions/<YYYY>/<MM>/<DD>/rollout-*.jsonl | session_meta / turn_context 的 cwd |
dsh(DeepSeek Harness) | ~/.dsh/sessions/<slug>/session-<uuid>/session.v{2,4}.jsonl[.zstd](支持 zstd 分帧压缩) | 开篇 session 记录的 cwd |
grok | ~/.grok/sessions/<percent-encoded cwd>/<uuid>/chat_history.jsonl(+ 同目录 events.jsonl / rewind_points.jsonl / updates.jsonl / summary.json / goal/*.md) | summary.json 的 info.cwd;目录名本身就是 cwd 的百分号编码,可反解 |
所有会话被归一为同一组 TurnEvent:user / assistant / thinking / tool_call / tool_result。
两家新来的各自带一个别人没有的麻烦,都在解析层吃掉了:
zstdDecompressSync 和 createZstdDecompress 都只解第一帧就停——不报错,只是安静地
少给你 99% 的会话。src/util/zstd.ts 按 RFC 8878 的帧头逐帧走位(不解压就能算出每帧
边界),整文件读全;正在写入的半截尾帧丢掉而不是毒化整个会话。chat_history.jsonl 里一个时间戳都没有。时间、工具成败、后台回执分散在同目录
的侧文件里:events.jsonl 的 tool_started/tool_completed(按 tool_call_id 对上,给
出耗时与 outcome)、rewind_points.jsonl 的 prompt_index → created_at(用户消息的
确切时刻)、updates.jsonl 的 ACP 流(助理消息与思考的时刻,按文本本身对上而不是按
位置猜;对不上就宁可不给时间戳)。token 记账也只有 updates.jsonl 有,没有这个文件的
会话就如实不报 token。npm install @1agents/session-reader # 作为库
npm install -g @1agents/session-reader # 作为 1session 命令
npx @1agents/session-reader list # 不安装直接用
要求 Node.js >= 22.15(node:sqlite 建索引,node:zlib 的 zstd 读 dsh 的压缩会话;zstd 是 22.15 才进 node:zlib 的)。
运行时依赖为 @1agents/chat-ui、@1agents/dreammate-network、@1agents/dreammate-node 和 preact,由包管理器自动安装。解析与索引使用 Node.js 文件、压缩及 SQLite API;不需要另装数据库服务。
1session 自带一个 skill(skills/1session/),装进各家智能体自己的 skills 目录后,
它们在用户问起"上次/之前/那个报错"时会自己想起来调这个 CLI,而不需要你每次手动贴命令。
1session skill install        # 链接到五家(未安装的智能体会跳过)
1session skill status         # 看五家各自是什么状态
1session skill uninstall      # 撤掉
| 智能体 | 落位 |
|---|---|
| claude | ~/.claude/skills/1session |
| codex | ~/.codex/skills/1session |
| antigravity | ~/.gemini/antigravity/skills/1session(不是 ~/.gemini/skills,那是 gemini-cli 的位) |
| grok | ~/.grok/skills/1session |
| dsh | ~/.dsh/skills/1session |
五家的格式完全一致(<dir>/<name>/SKILL.md + YAML frontmatter),所以装的是同一份文件。
默认建符号链接而不是拷贝:下次 npm i -g @1agents/session-reader@latest 升级后,
各家看到的 skill 自动就是新的,不用记着重装。Claude Code 实测会跟随符号链接并热加载。
如果某家的加载器不认符号链接(表现是 status 显示已链接、但智能体里看不到这个 skill),
用 1session skill install --copy 换成拷贝——代价是升级后要重跑一次安装,status
会把"拷贝与当前包不一致"显式标出来。
其他开关:--agent claude,codex(只装指定的几家,即使该智能体尚未安装也会建目录,
方便先装 skill 后装智能体)、--dry-run(只说会做什么)、--force(覆盖同名条目)。
别用 npx 跑 skill install。 默认的链接模式会指回包所在目录,而 npx 装的那份在
~/.npm/_npx/<hash>/ 的缓存里,npm 自己会清。清掉那天五家的 skill 一起静悄悄消失。
先 npm i -g 再 skill install;实在要从 npx 引导就加 --copy,把字节交给各家自己拿着。
传播给别人时,两行就够——第二行是大家会忘的那行:只装 CLI 的人得自己记着它存在, 两行都跑了的人是智能体替他记着。
npm i -g @1agents/session-reader
1session skill install
skill 自己也带着这套安装说明(skills/1session/references/install.md):即便对方只拿到
一份 SKILL.md、机器上没有 CLI,它也会先用 npx 把问题回答掉,再回头提一次永久安装。
# 开发态(无需构建)
npx tsx bin/1session.ts <command>

# 构建后
npm run build && node dist/bin/1session.js <command>
| 命令 | 说明 |
|---|---|
1session list [--limit n] [--scope <path>|cwd|global] [--provider name] [--since 24h] [--json] | 按最近更新列出各智能体的会话(默认当前 pwd 子树,见 --scope) |
1session projects [--weekly] [--page n] [--limit n] [--project-map file.json] [--timezone zone] [--scope <path>|cwd|global] [--provider name] [--json] | 跨智能体合并项目,或按周统计项目历程,从新到旧分页(默认全部项目) |
1session overview <session-id> [--json] | 第 1 层:统计卡片(轮次/文件/命令/提交/产物/上传/后台任务/token)+ 目标、口径修正、状态锚点、全量落盘 |
1session turns <session-id> [--json] | 第 2 层:逐轮概要——时间、耗时、事件区间、文件/命令/失败数、用户说了什么、agent 回了什么 |
1session turn <session-id> <n> [--event k|a-b|a,b,c] [--json] | 第 3 层:默认读取用户与助手的可见正文、附工具目录;支持批量轮次、--locator、--call、--artifact、--raw 和游标分页 |
1session digest <session-id> [--focus marketing|review|full] [--json] | 单会话蒸馏:目标、改动文件、命令、关键节点 |
1session workspace [path] [--since 24h] [--limit n] [--digest] [--focus f] [--json] | 按 pwd 跨智能体聚合(默认 .);带 --digest 输出统一故事线 |
1session jobs <id> [--json] | 异步作业账本:状态 + 证据 + pid / host / log |
1session commands <id> [--failed] [--host h] [--turn n] [--json] | 命令账本:exit_code / 耗时 / cwd |
1session files <id> [--group project|runtime|log|all] [--json] | 文件账本,按项目 / 运行态 / 日志分组 |
1session errors <id> [--json] | 失败命令,带 stderr 与"同前缀命令后续是否成功" |
1session search <query> [--scope <path>|cwd|global] [--since 24h] [--limit n] [--kind k1,k2] [--regex] [--case] [--context n] [--max-hits n] [--include-self] [--json] | 关键词检索:默认搜对话与已落盘标题 / 摘要;--area 选择工具或产物,--session 限定会话,支持排序、分组与游标 |
1session index [<id>] [--all] [--scope <path>|cwd|global] [--force] [--since 30d] | 建立 / 刷新索引;--all 全库回填 |
1session graph <id> [--json](别名 related) | 会话之间的引用关系 + 每条边的证据 |
1session skill install|status|uninstall [--agent a,b] [--copy] [--force] [--dry-run] | 把内置 skill 装进五家智能体的 skills 目录(见上) |
全局开关 --no-index 绕过索引直读源文件。
1session projects                           # 全部智能体的项目,第 1 页,每页 20 个
1session projects --page 2 --limit 10        # 第 2 页,每页 10 个项目
1session projects --scope .. --provider codex --json
1session projects --weekly --timezone Asia/Shanghai --page 1 --limit 4 --json
1session projects --project-map projects.json --weekly --timezone Asia/Shanghai
项目跨智能体归并:同一完整工作目录、同一 Git 仓库的子目录和 worktree 合并;
同一 origin 的克隆也合并,SSH / HTTPS 地址归一化且不输出 URL 凭据。
独立嵌套仓库、不同 origin 的 fork 和没有仓库依据的同名目录分别保留。
Git 项目名取 origin 的仓库名,无 origin 时取仓库根目录名;普通项目取工作目录末级名称。
输出项目名、最近修改时间、智能体、会话数、历史目录数和项目路径。
这里的「最近修改时间」取该项目最新的会话创建时间,不取会话文件的修改时间。
没有创建时间的项目显示 ? 并排在最后;无法恢复工作目录的会话不计入项目列表。
历史目录即使已经删除,仍可从会话中列出。时间相同时按项目路径排序。
projects 默认跨全部项目,--scope cwd 可限定当前目录子树。先聚合、排序,再按项目分页,
--page 从 1 开始,--limit 默认 20,两者须为正整数。
JSON 返回 { projects, total, page, limit, hasMore, nextPage? };每个项目包含
id、name、workspace、workspaces、mergeSource、createdAt?、updatedAt?、sessionCount
和 providers。workspace 是代表路径,workspaces 保留全部观测到的历史工作目录;
mergeSource 为 workspace、git 或 mapping。末页省略 nextPage,
超出末页返回空 projects 并保留总数。
已迁移、删除或重命名且无法通过 Git 确认的目录,可用 --project-map projects.json 显式合并。
文件内容为数组,id 和工作目录不能重复;嵌套规则按最长目录前缀匹配,可将独立子项目单独保留:
[
  { "id": "app", "name": "统一项目", "workspaces": ["/work/current/app", "/work/old/app"] },
  { "id": "reader", "name": "会话读取工具", "workspaces": ["/work/services/reader", "/work/old/app/modules/reader"] }
]
映射优先于自动 Git 归并,不依据同名或对话文字猜测身份。相对路径相对于 CLI 当前目录解析, 建议使用绝对路径。映射只影响查询结果,不修改历史文件。
--weekly 按每条会话的创建时间统计周一至周日,默认使用本机时区,
--timezone Asia/Shanghai 可显式选择 IANA 时区。先对所选范围的完整历史合并项目,
再按自然周倒序分页;--limit 此时是每页周数。首末记录之间的空白周也保留。
--scope 和 --provider 限定统计样本,因此首次出现和累计数也以所选样本为准。
周度 JSON 返回 { weeks, total, page, limit, hasMore, nextPage?, timeZone, undatedSessionCount }。
每周包含 week、endDate、projectCount(活跃项目数)、newProjectCount(首次出现)、
cumulativeProjectCount(累计)、sessionCount、providerSessionCounts 和 projects。
周内项目按会话数倒序,含统一项目 id、名称、代表路径、会话数、各智能体数量和 isNew。
缺少有效创建时间的会话不计入周度统计,在 undatedSessionCount 中单列。
统计包含可归属工作目录的全部会话文件,不自动剔除空会话、测试或审批回放。 首次出现不等于实际立项,空白周不等于停工,会话数量不等于工时;最近一周可能尚未结束。
检索只使用已落盘内容与确定性规则,不生成 AI 概要,不引入向量检索。
--area | 可搜索字段 |
|---|---|
dialogue(默认) | 用户 / 助手可见正文、当前标题、已保存的 AI / 自定义标题、provider 已保存的会话摘要 |
tools | 工具名、参数、结果;Antigravity 可恢复的完整输出也参与检索 |
artifacts | 已识别产物的名称、路径、摘要与文本正文 |
all | 上述三类合并;仍不包含 thinking |
--kind 显式限定事件类型时,只搜索指定事件。默认轮次阅读保留所有可见消息的顺序、换行与代码块,
工具参数 / 结果按需读取;thinking 和指令封套不进入默认预览。系统提示词没有统一字段:--raw 可核对所选事件记录中保存的指令封套;
未对应归一化事件的独立系统记录,仍需打开源文件查看。不补造缺失内容。
1session search 'src/ledger.ts' --global --area tools
1session search '发布 npm' --global --sort time
1session search ignored --global --terms '["发布","完成"]' --operator and
1session search '超时' --global --session 'claude:<完整原生ID>' --max-hits 10 --json
1session turn 'claude:<完整原生ID>' 2-4 --json
1session turn 'claude:<完整原生ID>' --locator '<命中的event:引用>' --json
1session turn 'claude:<完整原生ID>' --call '<原生调用ID>' --json
1session turn 'claude:<完整原生ID>' --artifact '<命中的产物路径>' --json
1session turn 'claude:<完整原生ID>' --locator '<event:引用>' --raw --json
普通 query 是一个字面字符串,空格不会自动分词。--terms 提供明确的 AND / OR 条件;
AND 在同一消息的字段内匹配,也可跨同一原生工具调用的参数与结果匹配,不拼接无关轮次。
默认按字段优先级(标题、对话 / 工具名 / 参数、结果等)、时间倒序与稳定 ID 排序;
--sort time 优先时间。事件缺少时间时使用会话更新时间,并标记 timeSource: session。
JSON 返回命中字段、字符区间、片段、轮次 / 调用分组,以及未展示数量和 nextCursor。
每个字段最多展示 20 个字符区间,更多区间用 hasMoreRanges 标明;原文不受该展示上限影响。
推荐保存 provider:完整原生ID 与事件 locator。短 ID 仅允许唯一匹配;重名直接报错并列候选,
即使索引只收录了部分会话也会核对源目录。Tn / En 是当前解析下的便捷序号,不作为持久 ID。
有原生记录 ID 时 locator 随追加保持稳定;缺少原生 ID 时使用记录序号与校验和,源记录改写后拒绝旧引用。
工具结果只按原生调用 ID 关联;没有 ID 的调用标为 unconfirmed,不猜测相邻结果。
turn 默认每页最多 32,000 个字符,可用 --max-chars 调整,接着用相同选择器和 --cursor 继续。
正文保持原始换行与代码块;JSON 的 offset / totalChars 表明读取进度。--raw 要求 --event 或
--locator,读取对应的原始 JSONL 记录(含默认视图隐藏字段)。来源发生相关变化时游标报错,要求重新读取。
provider 已截断且没有旁路原文时会明确提示;索引和分页不会再次丢弃尾部。
共享 TypeScript API 为 readTurnDirectory、readTurns、readEvents、readOriginalRecords、readCall、
readArtifact。HTTP 使用 /v1/sessions/<id>/content?turns=2-4,或 event=<locator>、call=<id>、
artifact=<path>;附 raw=true 可读原始事件记录。面向 agent 的 CLI / DSH 工具使用相同检索核心与游标协议。
索引新增轮次区间与事件 / 调用索引,局部读取只加载所选范围;首次升级按现有缓存策略重建一次。
--scope:会话按路径子树取list / search / index --all 默认只看当前 pwd 这棵子树下的会话;跨项目要显式说出来。--scope 取三种值:
| 值 | 含义 |
|---|---|
省略 / cwd | 当前 pwd 及其所有子目录下的会话 |
相对路径(..、../web、~/proj)或绝对路径(/Users/me/proj) | 该目录及其所有子目录下的会话 |
global(或 --global,或 --scope /) | 全部会话 |
按子树取而不是按目录相等取:--scope ~/Documents 会列出 ~/Documents 下每一个项目的会话,而不只是恰好在 ~/Documents 里启动的那几个。目录写错会直接报错,不会静悄悄地返回"0 个会话"。
1session list                        # 当前项目(含子模块)
1session list --scope ..             # 连同同级的兄弟项目
1session list --scope ~/Documents    # 这棵树下的全部项目
1session list --global               # 全部
1session search "超时" --scope ../..  # 在祖父目录这棵树里检索
1session index --all --global        # 全库回填索引
(--workspace <path> 是路径形式的旧拼法,仍然可用,优先于 --scope。)
路径从哪来(各家各写各的,读之前先归一):
| Provider | 项目路径 | 时间 |
|---|---|---|
| claude | 目录名 = cwd 的 slug(~/.claude/projects/-Users-me-proj/),每行 JSONL 另带 cwd | updatedAt = 文件 mtime;createdAt = 首行 timestamp |
| codex | 目录只按日期分(~/.codex/sessions/YYYY/MM/DD/rollout-*.jsonl),路径只在 session_meta / turn_context 的 payload.cwd 里 | updatedAt = mtime;createdAt = session_meta.timestamp,兜底解析文件名里的时间戳 |
| antigravity | transcript 里没有 cwd,但 IDE 自己维护着项目↔会话的关系:~/.gemini/antigravity/conversations/<id>.db 的 trajectory_metadata_blob 里存着打开的目录(protobuf 字段 1.1,file:// URI;1.2 是外层 workspace 根,1.4 是 git 分支)。读它,读不到才退回从工具参数里猜 | updatedAt = mtime;createdAt = 首个 step 的 created_at |
| dsh | 目录名是 cwd 的有损编码(- 同时代表 / 和字面 -),只当参考;真 cwd 在开篇 session 记录的 cwd 里。scanRef 只解压文件头 64KB——zstd 帧自带边界,取前缀就等于取会话前缀 | updatedAt = mtime;createdAt = session.createdAt(epoch 毫秒) |
| grok | 目录名是 cwd 的百分号编码,decodeURIComponent 就能无损还原,所以带 --scope 时可以在开文件之前就筛掉不相干的会话;summary.json 的 info.cwd 是正式答案 | updatedAt / createdAt 直接取 summary.json;候选发现时的 mtime 取 chat_history.jsonl 与 summary.json 里较新的那个 |
排序和 --since 都只用 mtime,listCandidates() 一次 stat 就够,不必打开文件 —— 打开文件(拿标题、cwd、创建时间)才是贵的那一步,所以它走索引缓存。
Antigravity 的 626 个会话里,本机有 14 个至今没有路径 —— 不是没读到,是 IDE 自己把它们标成了 outside-of-project(开着聊天窗口、没开文件夹时起的会话)。这类会话只在 --global 下出现。
list / workspace / search 都走索引:先对每个会话文件做一次指纹检查(size + mtime + 头部哈希),只有字节动过的才重新解析,然后用一条 SQL 出结果。所以:
--scope 再大也不会悄悄丢掉更早的会话;list 约 0.5s;--no-index 仍然可以绕开索引直读源文件,两条路的结果应当逐条一致(可以 diff 验证)。升级到这一版后,索引会因为 PARSER_VERSION / EXTRACTOR_VERSION 提升而自动重建一次(新增 grok / dsh 两家,写文件工具表也跟着补了 search_replace 与 run_terminal_command),无需手动清库;想主动做可以跑 1session index --all --global。
<session-id> 支持完整 id、id 前缀(≥6 位)或原始文件路径。
1session workspace . --since 24h --digest --focus marketing
三层下钻——先看全局,再定位到轮次,最后钻进单次工具调用:
1session overview 01a0907c # 第 1 层:这个会话到底干了什么
## 统计
| 轮次 | 事件 | 文件改动 | 命令 | 失败 | 提交 | 产物 | 上传 | 后台任务 |
| 15 | 923 | 15(31 次) | 336 | 27 | 0 | 0 | 0 | 0/0 完成 |
事件构成:user 15 · assistant 89 · thinking 143 · tool_call 338 · tool_result 338 | token:入 51105.9k / 出 185.4k
1session turns 01a0907c # 第 2 层:15 轮,每轮干了什么、花了多久
T 3 2026-09-11T13:03:29 (283s)  事件 29–45  文件 1 · 命令 7 · 失败 0
    ▸ ### 🎉 阶段性重大进展:MiniMax-H3 首次文生视频测试成功落地!…
    ◂ 已经查到一个明确的配置问题:这版 H3 的 `num_inference_steps=4` 实际只执行 3 次去噪…
1session turn 5575981e 1 --event 11      # 第 3 层:单次工具调用的完整输出
1session turn 5575981e 1 --event 11-13   # 连着看:调用 + 结果 + 助理的判断
--event 收 11、11-13、11,15,22 及其混合,一次最多 50 条;区间会按会话长度裁剪,
所以 560-999 就是「看到结尾」。读一次工具调用通常要连读它的结果和后面那条助理判断——
一个进程读完,而不是起三次。
第三层会自动补全被截断的内容:antigravity 的 transcript.jsonl 会把长输出截短(事件 #11 只存了 4092 字符),命令会回读 .system_generated/steps/8/output.txt 拿到完整的 6937 字节并标注 [已从 steps/ 补全];补不回来时如实提示 ⚠️ steps/N/output.txt 不存在。
跨会话检索(--kind 可过滤轮次类型,只看用户说了什么 / 只看工具调用):
1session search "xhs|小红书" --regex --workspace ~/proj --since 24h --kind user
4 处命中,分布在 2 个会话
(已折叠 1 处本次检索自身留下的回声;--include-self 展开)

### antigravity 5575981e  2026-09-13T00:21:05Z → 2026-09-13T03:31:58Z  (2 命中)
  T7 · E318 user  /xhs-tech-card 结合 docs/xhs_sol_h3_spark_output/index.html,第一次实战经验贴。
  T9 · E441 user  /mobile-xhs-publisher
    ↳ 1session turn 5575981e 7 --event 318
事件命中携带 T<轮次> · E<事件号> 和稳定 locator;标题、摘要、产物命中属于会话层,
不伪造轮次。每组附可直接执行的读取命令。
默认折叠本次检索自己留下的脚印:调用方的会话是边跑边索引的,1session search "X" 这条
命令本身(以及它打印出来的东西)会立刻成为 X 的第一条命中。判据只有一条——五分钟内写下的
1session 调用及其结果;只有活着的那个 transcript 才可能有「此刻」的时间戳,所以历史会话一条
都不会被碰到。折叠了多少永远会打印出来,--include-self 可以全部展开。
输出示例(上午 Antigravity 定方案 → 下午 Claude Code 落地实现,自动交织成一条时间线):
# 1agents_app · 跨智能体协作纪实
- 参与智能体:antigravity / claude
- 会话:2 个,统一时间线 12 个节点,涉及 1 个文件

## 统一时间线
- `2026-09-13T03:21:37Z` **antigravity** 提出:在 ./modules/ 创建一个 session-reader 的子模块…
- `2026-09-13T03:27:50Z` **antigravity** write_to_file → implementation_plan.md
- `2026-09-13T03:33:34Z` **claude** 提出:参考 implementation_plan.md,立即开始编码实现!
- `2026-09-13T03:36:52Z` **claude** 失败:src/resolver.ts(38,79): error TS1127: Invalid character.
import {
  listRecentSessions,
  listProjects,
  listProjectWeeks,
  findSessionsByWorkspace,
  loadSession,
  parseSession,
  distillSession,
  aggregateWorkspaceSessions,
  searchSessions,
  buildOverview,
  summarizeTurns,
  turnDetail,
  eventDetail,
  eventDetails,
} from '@1agents/session-reader';

const sessions = await findSessionsByWorkspace(process.cwd(), { since: '7d' });
const projects = await listProjects({ page: 1, limit: 20 });
const weeks = await listProjectWeeks({ timeZone: 'Asia/Shanghai', page: 1, limit: 4 });
const digest = distillSession(await parseSession(sessions[0].id), { focus: 'marketing' });
const story = await aggregateWorkspaceSessions(process.cwd(), { since: '24h' });
const hits = await searchSessions('小红书', { workspace: process.cwd(), since: '24h', kinds: ['user'] });
const session = await loadSession('01a0907c'); // 走索引;parseSession 直读源文件
const overview = buildOverview(session);      // 第 1 层:overview.stats / overview.markdown
const turns = summarizeTurns(session);        // 第 2 层
const detail = turnDetail(session, 3);        // 第 3 层
const full = await eventDetail(session, 11);  // 第 3 层:未截断的单次工具输出
const around = await eventDetails(session, '11-13'); // 相邻几条一起读
hits[0]?.matches[0]?.turn;                    // 命中所在轮次,与 match.index 凑成 T·E 句柄
searchSessions 另接 selfSessionId 显式指明调用方(默认取 SESSION_READER_CALLER_SESSION);
被判定为「调用方自己」的命中不会被删掉,而是带上 self / suppressed 标记返回,展不展示由调用方定。
aggregateWorkspaceSessions 返回 WorkspaceDigest:sessions / collaboratingAgents /
unifiedTimeline(按时间排序的跨智能体节点)/ fileAttribution(文件 → 谁在什么时候改的)/ markdown。
适合直接喂给下游做小红书笔记、PRD、周报与 changelog,也可零成本包成 DeepSeek Harness(Cordis)插件或 MCP server。
(注意与下文「索引」的 L0–L3 不是一回事:那是数据存在哪,这里是事实可信到什么程度。)
| 档 | 内容 | 例子 |
|---|---|---|
| 源文件显式字段 | 各家自己记好的结构化数据,零猜测 | codex CommandExecution 的 336 条命令(带 exit_code/stderr/pid/duration)、FileChange、token 记账;claude 的 gitBranch/model/usage;antigravity 的产物 metadata、上传、任务回执 |
| 确定性规则派生 | 纯规则,可重复、可验证 | antigravity 打印的 The command exited with code N → 211 条 exit_code;ssh user@host → 主机;git commit -m + [branch sha] 回显 → 提交;路径按项目/运行态/日志分组;每个资源的首见/末见轮次 |
| 语义解释 | 本模块不做 | 当前主线、目标漂移、已完成/阻塞/下一步、决策归纳、坑的因果链、资源的 primary/legacy 角色 |
所以 overview 回答的是"最后一条成功命令是什么",而不是"当前阻塞是什么";给出"末态事实"而不是"进度判断"。语义层留白处会显式写明 属语义层,本阶段不生成,不假装。
每条事实都带 provenance 与 extractor,回答"你为什么认为这是事实、来自哪个事件、用什么规则提取":
| 级别 | 含义 | extractor 例子 |
|---|---|---|
observed | provider 自己记的结构化字段 | tool:Write、item:FileChange、item:CommandExecution、receipt:messages |
derived | 对确实执行过的动作施加确定性规则 | shell:redirect、shell:scp、pair:tool_call+tool_result |
candidate | 仅在文本里被提到,没有任何人动过它 | text:path-mention(只出现在「资源」一段) |
1session files 3ab9fe0e --group all
[project] derived   T1 src/types.ts `shell:redirect E42`
[runtime] observed  T5 ~/.claude/plans/codex-01a0907c-….md `tool:Write E206`
[project] derived   T7 src/ledger.ts `shell:redirect E415`
文件账本永远不含 candidate——路径只有在证明发生过写操作后才会进来。「资源」一段是唯一收纳 candidate 的地方,标题里写明了。
先证明发生了文件操作,再抽路径——而不是看到像路径的字符串就当成文件。具体地:here-doc 的正文(正在被写入的数据)在分析前会被剥离,否则里面的源码会伪装成命令——(a, b) => b[1].length 里的 > 会被当成重定向,payload 里的 ssh admin@1.2.3.4 会被当成真连过的主机。裸 token 还必须带真实扩展名,否则 r.source、a.name 都会被当成文件。
每条事实后面带 Evidence Handle(E<事件号> · T<轮次>),可以直接下钻验证:
1session turn 3ab9fe0e 9 --event 491
同样的原则贯穿每一处:没有证据就不断言。异步作业只在有完成回执时标 completed,否则一律 unknown 并写明依据;没有打印 exit code 的命令结果,exitCode 就是空,绝不补成 0。
observed / derived / candidate 回答的是这个事实怎么来的,不是它现在还对不对。
overview 的「末态」恰恰是最易腐的一段:
凡是关于当前状态的问题(凭据、环境变量、装了哪个版本、文件还在不在),会话只能告诉你 它最后一次为真是什么时候——去核实。转录记下的是说过什么和退出码,不是效果。
三种真实撞上过的情况:一条命令退出码为 0、无报错,但它读到的是空输入,写进配置的是个空值; 某一轮的结论说「现在存了三份」,其中一份是只活在当时那个 shell 里的临时函数,从没落盘; 「某某已配好」在当时是对的,三周后需要另外验证。会话忠实记录了意图和退出码,记不下效果—— 这是转录这种载体的边界,不是提取规则的疏漏,所以本模块不打算用更聪明的规则去补它, 只把话说清楚。
第二层每一轮带一个有证据的状态——只说这一轮有没有收尾,不说做成了什么:
| 标记 | 状态 | 判据 |
|---|---|---|
✓ | completed | 有原生 task_complete,或以 assistant 收尾且下一轮不是催促 |
⚠ | unfinished | 有 task_started 但没有配对的 task_complete |
↻ | nudged | 下一轮是纯推进指令(继续/continue),记连续次数 |
✂ | interrupted | 轮内有 tool_call 却没有对应结果 |
⊘ | no_response | 除用户消息外没有任何助理事件 |
✗ | failed_tail | 以 exit ≠ 0 收尾且其后无 assistant |
多条证据可以同时命中,此时置信度更高。实例:
⚠ T 9 ... [unfinished ×2]
    ! provider 记录了 task_started 但没有配对的 task_complete(turn 01a095f4-5b27);下一轮是纯推进指令,连续 2 次("contin")
这一轮切换到 Sol-H3-Spark 没跑完 → 用户打了 contin → 又打 continue。两条独立证据指向同一结论,不需要模型参与。
stat),再按需读文件头填充元数据,最后才整篇解析。list 与 workspace 通常在 0.5 秒内返回。--since 的精度:预筛用文件 mtime(可能因同步/复制而失真),--digest 会在整篇解析后用真实轮次时间戳再过滤一次。list 只读文件头,标题取首个用户请求;inspect/digest/workspace --digest 会整篇解析,此时优先使用会话自身的 custom-title / ai-title。search 没有扫描上限。早先它受发现层的扫描预算限制,一次查询其实只看最近 ~60 个会话/每个智能体,却把结果报告得像查全了——"静默不全"比慢危险。现在 --limit 只管返回几个会话,不再兼任"最多检查几个会话";满足 --workspace / --since / --provider 的会话一个不漏。默认每个会话最多列 5 处命中,totalMatches 给的是真实总数。observed 来自显式写工具(Write/Edit/write_to_file/replace_file_content/apply_patch/grok 的 search_replace)与 provider 自己记的 FileChange;derived 是从 shell 命令里解析出来的(>/>>、tee、cp/mv、scp、sed -i、python 的 write_text/open(w))。没有后者,纯靠 shell 干活的智能体(如 codex 全程走 exec 沙箱)会显示成"一个文件都没改过"。这是启发式,可能漏也可能多报,所以每行都写明是哪条规则提取的。task_started 总比该轮第一个事件早几秒(12:41:06 vs 12:41:13),按"落在窗口内"匹配会全部落空。event_msg/item_completed 里有 FileChange(带 diff)、CommandExecution(带 pid/cwd)、task_started/task_complete(轮次边界 + 耗时)与 token_usage_record;claude 每条都带 gitBranch/model/usage;antigravity 的产物、上传、后台任务分别在 brain 目录、.user_uploaded/ 与 .system_generated/{tasks,messages}/。统计里 filesByProvenance 给出这次的 observed / derived 分项计数。input_tokens 平均只有 2,而 cache_read_input_tokens 平均 30 万(重读整个缓存前缀);把后者计入输入会让一个 20 万上下文的会话显示成 1.16 亿 token。现在 input 只含真正写入模型的部分,缓存复用记在 cacheRead。stats.errors 与 1session errors 永远是同一个数。overview 的统计、overview --json 的 writes、1session files --group all 三者行数恒等,且 project + runtime + log 必须刚好铺满(有测试钉住)。filesChanged 是去重后的文件数,fileChangeEvents 是写动作次数(同一文件写三次算三次),两者定义不同所以可以不等。混合账本不给单一来源标签,而是给 observed / derived 的分项计数。ssh user@host '…' 时,其中的写标记为 host:/path;但 scp remote:src local_dst 是往本地写,host 只认目标端自己写明的那个。~/.1agents/session-reader/index-v3.db(SQLite,SESSION_READER_DB 可改)。任何命令碰到一个会话都会顺手索引它;1session index --all 做全库回填。
索引因沙盒权限或只读文件系统无法打开、创建或写入时,搜索、列表和会话读取会自动降级为直接读取原始文件,并向 stderr 输出提示;stdout 的 JSON 格式不变。降级可能较慢,仍需原始会话的读取权限。也可用 --no-index 主动绕过索引,或在旧版本中重试。显式 index 和依赖索引的 graph 仍需可写索引;数据库损坏等其他错误会正常报出,无需复制数据库或删除 WAL/SHM 文件来绕过权限限制。
L0  各家原始 JSONL                        ← 永远是唯一真相
L1  归一事件  sessions / events
L2  确定性事实  file_ops / commands / jobs
L3  会话关系  session_edges / edge_evidence
四个版本号各管一层(src/store/schema.ts),这是分层的实际收益:
| 变了什么 | 代价 |
|---|---|
源文件指纹 或 PARSER_VERSION | 重读文件,L1/L2/L3 全部重建 |
EXTRACTOR_VERSION | 一个字节的 JSONL 都不读,从 events 行重新推导 L2 |
EDGE_VERSION | 同上,只重推 L3 |
SCHEMA_VERSION | 删库重建(L0 能重建全部,不写迁移代码) |
指纹 = 大小 + mtime + 文件头 64KB 的 sha256。没有"会话是否结束"这个概念——指纹没变就是没变。
事件文本整条存,不截断。曾经按 128KB 封顶,实测代价是全库 622 个会话里只有 7 个事件超限、省下 0.08% 的体积,却让 search 漏掉长构建日志里的命中(--deployment-target 正好落在切口之后)——用 0.08% 换一个"看起来查全了其实没有"的答案,方向反了。本机实测:622 个会话首次回填 7.5s,索引 297MB。
索引只许加速事实,不许改动事实。测试里钉着一条往返等价:三个 provider 各取一个真实会话,parse() 的结果与索引读回的结果必须 deepStrictEqual,buildOverview 的 markdown 也必须逐字相同。命令行上随时可复核:
diff <(1session overview <id>) <(1session overview <id> --no-index)
search 不再把 622 个会话还原成对象——那一步比其余所有环节加起来还贵(实测 1.33s)。现在是 SQL 预筛 + 原有正则裁决:
Query
  ↓  planQuery:能不能证明出一个"必然出现"的子串?
SQL  instr() 预筛(外加 workspace / kind / since 下推)
  ↓
现有 regex matcher ← 唯一的语义权威
Hit
分三档:
| 查询 | 处理 |
|---|---|
字面量 src/ledger.ts、会话 | 直接 instr() 预筛 |
正则且能安全抽出必然子串 src/.*ledger\.ts → ledger | instr() 预筛 + 正则裁决 |
DeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
把回答做成一页可视化 HTML:模型只写简短的 Markdown 草稿,随包附带的 `am` 命令行生成页面,支持流程图、时序图、树、时间线、ER 图、表格和提示框。
在 dsh 里装上这个插件即可,无需登录、注册或填 API Key,就能使用包括 Muse Spark 1.3、MiMo V2.6 在内的前沿模型——完全免费,不限量。 All you do is install this plugin in dsh: no login, no sign-up, no API key — the frontier models are just there, Muse Spark 1.3 and MiMo V2.6 among them. Completely free, with no usage cap.

