
dsh-web
zhu1090093659/dsh-webDeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)

DeepSeek Harness 的本地实时语音转写:右下角浮窗,边说边出字,Qwen3-ASR 本地推理,完全离线。
在 DeepSeek Harness 里做本地实时语音转写:右下角一个浮窗,边说边出字,可存成 markdown 纪要。识别引擎是本机的 Qwen3-ASR-1.7B-8bit(MLX),音频不出机器。
English | 简体中文
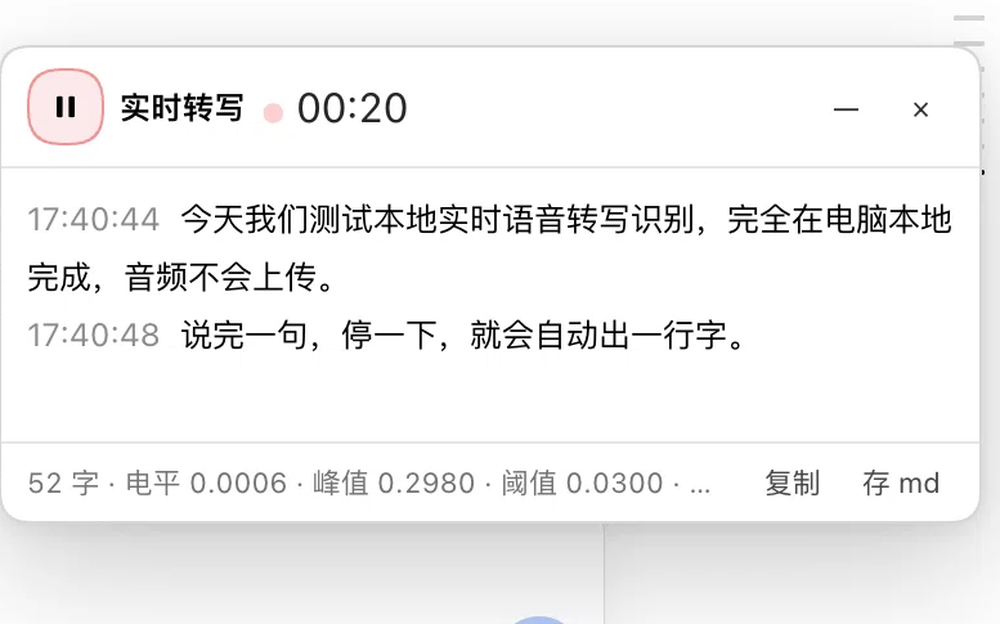
边说边出字:每句停 0.95 秒后出一行,可暂停/最小化继续录,可复制或存成 markdown。
方式一:npm(推荐)
dsh plugin --profile desktop add dsh-plugin-local-voice
方式二:直接从 GitHub 装(想跟最新提交时用)
dsh plugin --profile desktop add github:R0tten-Git/dsh-plugin-local-voice
方式三:插件页
插件页 → 添加插件 → 指向本目录(或 .tgz)→ 安装 → 立即启用。
装完还要准备引擎(macOS Apple Silicon):
uv venv ~/.local/venvs/mlx-audio --python 3.12
~/.local/venvs/mlx-audio/bin/pip install "mlx-audio==0.5.5" sounddevice numpy huggingface_hub

# 模型:默认走魔搭(国内快,不需要装 modelscope SDK)
python3 scripts/prepare_model.py
# 海外可换源:--source hf-mirror / --source hf
🎙 实时转写| 平台 | 浮窗 UI | Qwen3 引擎 | 说明 |
|---|---|---|---|
| macOS Apple Silicon | ✅ | ✅ | 推荐,中文效果最好 |
| Windows / Linux | ✅ | ❌ | Qwen3 不注册,自动回落官方 SenseVoice,UI 照常可用 |
| Web 客户端 | ✅ | 取决于 Host | 模型跑在 Host 上 |
插件启动时自动探测平台(darwin/arm64)+ Python 解释器 + 模型目录,三者任一不满足就不注册 Qwen3 识别器,也不去改默认识别器——所以你看到的是 SenseVoice 正常工作,而不是一个坏掉的麦克风。
| 控件 | 作用 |
|---|---|
| 点右下角胶囊 | 开始录音并展开浮窗 |
| ▶ / ⏸ | 开始 / 暂停(暂停保留内容) |
| — | 最小化,继续录音 |
| × | 结束本次转写并清空(有内容时二次确认) |
| 复制 / 存 md | 复制全文 / 存成 markdown |
| 环境变量 | 默认值 | 说明 |
|---|---|---|
LIVE_STT_MODEL | ~/models/Qwen3-ASR-1.7B-8bit | 模型目录 |
LIVE_STT_PYTHON | ~/.local/venvs/mlx-audio/bin/python | 带 mlx-audio 的解释器 |
LIVE_STT_MODEL_SOURCE | modelscope | 缺模型时提示里用的镜像源 |
LIVE_STT_LLM_VERIFY | off | 逐句 LLM 校对(走 DSH 模型通道) |
| 项 | 说明 |
|---|---|
| 麦克风 | 浏览器/系统层授权,录音只在页面内进行 |
| 本地进程 | 会拉起一个 Python 进程跑 Qwen3(只读模型目录,不写系统路径) |
| 网络 | 默认零外网。模型下载是你手动执行脚本时才发生;LIVE_STT_LLM_VERIFY=on 会走 DSH 的模型通道 |
| 文件 | 只在用户点击「存 md / 存 wav」时通过系统文件选择器写入 |
| 数据 | 音频不落盘、不上传;日志写在 ~/Library/Logs/dsh-qwen3-asr.log |
MIT
最初这个包只做一件事:给 DSH 自带的语音输入加一个键盘快捷键(⌘D)。后来扩展成识别器 provider 和独立浮窗。
除了快捷键和识别器,这个包现在还往输入框下方的 conversation.composer.dock 槽位注册一个独立的实时转写面板,跟内置语音输入完全无关:
shell.overlay 槽位,380px 宽、最高 72vh,内容超出时窗内滚动)。— 是最小化:窗口收起但继续录音,右下角只留一个半透明的小计时标记(● 01:23),开会时干活不受挡。× 是结束本次转写:有内容时先变成红色「确认结束?」,3 秒内再点一次才清空并关闭,避免误删。ctx.remote.speech.transcribe,也就是走本包的 qwen3-asr-local provider。showSaveFilePicker 存到你选的位置,文件名默认 live-stt-YYYY-MM-DD_HHMM.md,内容带时间戳,可直接拿去整理纪要。HOTWORDS 领域词表(Qwen3-ASR 原生的 hotwords 偏置,在解码阶段压同音误识),以及一张极小的 FIXES 兜底替换表(只放正常中文里不会出现的错形,宁少勿多)。模型不随包分发,用 scripts/prepare_model.py 自己下。三个源,默认魔搭:
# 魔搭 ModelScope(国内推荐,直链 17 MB/s,无需安装 modelscope SDK)
python3 scripts/prepare_model.py

# 只下某个文件 / 指定目录
python3 scripts/prepare_model.py --include config.json --dest /tmp/x

# 其他源
python3 scripts/prepare_model.py --source hf-mirror
python3 scripts/prepare_model.py --source hf
--flavor | 仓库 | 大小 | 用途 |
|---|---|---|---|
mlx(默认) | mlx-community/Qwen3-ASR-1.7B-8bit | 2.47 GB | macOS Apple Silicon |
hf | Qwen/Qwen3-ASR-1.7B-hf | 4.09 GB | Windows/Linux 的 torch / onnx 后端 |
三个源上的仓库 id 完全一致(魔搭完整镜像了 HF 社区仓库),所以只换 URL 不换路径。
缺模型时插件日志会直接打印当前源对应的准备命令;用 LIVE_STT_MODEL_SOURCE 改默认源。
默认关闭。 打开后,识别完每一句都会用 DSH 自己配置的模型(默认 deepseek-account / deepseek-flash)过一遍校对,再返回给 UI。位置在 Host 的 provider 里,所以实时转写面板和内置麦克风都生效。
开启方式:LIVE_STT_LLM_VERIFY=on(放在 DSH 的启动环境里)。
浮窗 不会一会儿变 浮床)。LIVE_STT_LLM_MODEL / LIVE_STT_LLM_PROVIDER;改超时:LIVE_STT_LLM_TIMEOUT_MS。verifyText 第一步就返回原文,不读服务、不发请求。代价要说清楚:这会把“完全离线”变成“依赖 DSH 的模型通道”,并且每句多 0.5–2 秒。一场一小时的会议约 300 句,就是 300 次调用。
除了快捷键,这个包现在还注册一个本地识别器 provider,把内置麦克风的识别从自带的 SenseVoice 换成本机的 Qwen3-ASR-1.7B-8bit(MLX):
qwen3-asr-local,在语音输入的语言下拉里可选 auto / zh / en / yue / ja / ko。cordis.patch.yml 把 speech-to-text 的 defaultProvider 直接指向它;若被更高层配置压住,插件启动时还会用服务自己的 configure() 再切一次。qwen3_worker.py:常驻 python 进程,模型只 load 一次,stdin/stdout 走 ndjson。~/.local/venvs/mlx-audio(Python 3.12 + mlx-audio 0.5.5)与 ~/models/Qwen3-ASR-1.7B-8bit。路径可用 QWEN3_ASR_PYTHON / QWEN3_ASR_MODEL 覆盖。cordis.patch.yml 里 speech-to-text 那三行,或在识别器下拉里手动选 SenseVoiceSmall。Host 侧的 JS 改动需要重启一次 DSH 才会加载(客户端 HMR 不管 Host 模块)。
0.2.0-rc.2(本包针对随该版本打包的客户端 API 编写)。复制这个包目录(或 .tgz 压缩包)到目标机器后,任选一种方式:
A. 插件页(推荐给人工操作)
B. 交给 DSH agent(plugin_manager 可用时)
install_bundle(target: "<包目录绝对路径>", enabled: true)
安装后 ~/.dsh/profiles/<profile>/ 的 package.json 会多出这条依赖并把它加入 dsh.profile.bundles;cordis.patch.yml 由包自带,不需要手写。
| 运行环境 | 默认键位 |
|---|---|
| Desktop(macOS) | ⌘D |
| Desktop(Windows / Linux) | Ctrl+D |
| Web(macOS / Windows) | ⌘⇧D / Ctrl+Shift+D |
| Web(Linux) | 不绑定(Web/Linux 只允许 Mod+Slash、Mod+Shift+Comma/Period 等少数组合) |
改键位:设置 → 编辑快捷键(或 ⌘/ 打开速查)→ 搜索「语音输入」。默认键位与 DSH 内置命令无冲突(内置占用 B/P/T/N/K/O/G/F/A/、、/、\、W、R、Comma、Backquote 等组合)。
Esc:取消(沿用自带插件的行为)。voice.dictate(走 DSH 的 shortcuts 服务,可在设置里改键位);keydown 兜底:读取该命令的当前生效键位后自行匹配。macOS/Windows Desktop 的可配置命令只由原生桥分发,原生桥成功时主进程已消费事件、页面收不到,所以两条通路不会重复触发;只有原生桥漏掉时才由兜底接住。aria-label(开始录音 / Start recording / 打开语音输入引导 / Open voice input setup)定位,class 以 _trigger 结尾的按钮只作兜底。DSH 升级若改动这些文案,需要同步 client.js 里的 TRIGGER_LABELS。client.js 里的 DIAGNOSTIC 改成 true,触发时窗口顶部会显示一条黑底提示,写明走的是哪条通路、点了哪个元素、0.6 秒后是否出现录音栏。插件页删除本包即可;它只注册一条命令和一个 DOM 监听,不写任何其他文件。
DeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
把回答做成一页可视化 HTML:模型只写简短的 Markdown 草稿,随包附带的 `am` 命令行生成页面,支持流程图、时序图、树、时间线、ER 图、表格和提示框。
在 dsh 里装上这个插件即可,无需登录、注册或填 API Key,就能使用包括 Muse Spark 1.3、MiMo V2.6 在内的前沿模型——完全免费,不限量。 All you do is install this plugin in dsh: no login, no sign-up, no API key — the frontier models are just there, Muse Spark 1.3 and MiMo V2.6 among them. Completely free, with no usage cap.

