

dsh-web
zhu1090093659/dsh-webDeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
一个 DeepSeek Harness 插件(DSH plugin):上传 vLLM-Ascend / 昇腾 NPU 的 profiling 产物,自动完成文件校验 → 流式解析 → 独立可视化页面(六步流程)→ 结构化性能优化建议 → 优化前后对比 → Markdown/PDF 报告导出,并可以把某条优化建议一键交给昇腾算子 skills(AscendC 算子开发、单算子基准、重新采集)继续往下做。
分析结论不是"看一眼就下的判断":每一句结论都能追溯到具体指标、门限、产物字段与推算公式,并且区分 Prefill 与 Decode 两类负载。插件本身零运行时依赖(只用 Node 内置模块与浏览器原生 API,不打包任何第三方前端库)。
插件页面:http://127.0.0.1:<port>/vllm-ascend-profiler/
昇腾上的 vLLM 推理变慢时,常见疑问是"到底是 Host 调度、NPU 计算、跨卡通信,还是 H2D/D2H 拷贝拖慢的?"。CANN 与 torch_npu 会导出大量产物(trace_view.json、kernel_details.csv、op_statistic.csv、step_trace_time.csv …),但这些产物本身有若干"坑":
trace_view.json 是裸 JSON 数组(不是 {"traceEvents": [...]})、ts 是十进制字符串、导出中断时甚至缺少收尾括号;pid == "Host" 区分的,而是靠 process_name 元数据(Python / CANN / Ascend Hardware);Start Time(us) vs Task Start Time(us)、Type vs OP Type、Accelerator Core);step_trace_time.csv 表头不声明单位,实际写的是毫秒;step_trace_time.csv 的 Stage 列)。本插件把这些全部处理掉,并输出一份既能拿去开会、也能直接照着改配置的报告。这些结论不是猜的:解析器对目录结构、表头与命名约定的假设都记录在 docs/research/(每条带官方文档/源码引用)。
插件是零依赖的纯 ESM 包,只需要让 DSH profile 能解析到它。
dsh plugin --profile web add github:nutsDad/dsh-plugin-vllm-ascend-profiler
dsh plugin 会在 profile 目录执行 pnpm 安装,并因为本包声明了 dsh.bundle.patch 而自动把 dsh-plugin-vllm-ascend-profiler 追加进 dsh.profile.bundles。本包没有任何依赖、也没有 prepare/构建脚本,因此不需要 allowBuilds 放行。重启 profile 即可生效。
dsh plugin --profile web add file:D:\path\to\dsh-plugin-vllm-ascend-profiler
$profile = "$env:DSH_HOME\profiles\web"
New-Item -ItemType Junction `
  -Path "$profile\node_modules\dsh-plugin-vllm-ascend-profiler" `
  -Target "D:\path\to\dsh-plugin-vllm-ascend-profiler"
$env:DSH_HOME\profiles\web\package.json(注意不要写成带 BOM 的 UTF-8,否则 DSH 读取清单会直接报 SyntaxError):{
"dependencies": {
"dsh-plugin-vllm-ascend-profiler": "file:D:/path/to/dsh-plugin-vllm-ascend-profiler"
},
"dsh": {
"profile": {
"bundles": ["@deepseek-ai/dsh-base", "@deepseek-ai/dsh-web-app", "dsh-plugin-vllm-ascend-profiler"],
"patchReload": "live"
}
}
}
dsh --profile web。启动日志会出现:vllm-ascend-profiler: 分析页面位于 /vllm-ascend-profiler/(trace 解析、可视化与报告导出)
$env:DSH_HOME = "D:\tmp\.dsh-test"
dsh --profile demo --from-default-profile web --port 3099 --no-open
从 dsh.profile.bundles 中删除本包名(并删掉依赖与链接)即可完全卸载;插件不写任何持久化文件、不注册任何后台任务。
sidebar.footer.action 插槽,点击在新标签页打开分析页面);http://127.0.0.1:<port>/vllm-ascend-profiler/。三种方式,任选:
| 方式 | 适用场景 | 说明 |
|---|---|---|
| 拖拽/多选上传 | 常规 CSV + 中小 trace | 多个文件作为一个数据集依次上传,页面显示字节级上传进度 |
| 打包上传 | *_ascend_pt 目录整体 | 支持 .zip / .tar.gz(内存内解压,成员大小与数量有上限) |
| 按路径分析 | GB 级 trace_view.json | 服务端流式读取,不占上传带宽;默认限制在会话工作区内 |
没有现成产物也可以先试:samples/ 里已经放了 5 个可直接上传的 zip(共 0.96 MB)——quickstart.zip(2 步冒烟)、
host-schedule-bound.zip 与 host-schedule-bound-optimized.zip(优化前 / 优化后一对,用来试第 6 步)、以及跨卡通信与 NPU 计算两个场景;
也可以 node test/make-fixture.mjs D:\tmp\samples 自己生成(四个场景,含配对)。
解析是异步任务:页面轮询任务状态并显示「校验 → 解析 → 汇总 → 分析」四段进度与明细日志。大 trace 不会卡死页面:事件按预算做等距采样(通信/拷贝/长耗时算子全量保留),采样情况在页面与报告中明确标注。
页面是一个六步流程(导入产物 → 概览与定位 → 时序取证 → 占比归因 → 优化行动 → 优化后对比),顶部步骤条显示当前进度并可点击跳转。三个可视化模块共享同一个筛选状态:在泳道图里点选算子、在大类构成条里点选大类、在耗时分布图里点选方块,效果会同步到其它视图(对应条目高亮、其余淡出),筛选条件以可关闭的标签显示,Esc 一键清除。概览页的「查看方案」会把对应优化项直接带到第 5 步的第 ④ 环。
模块一 · Host / Device 算子执行泳道图
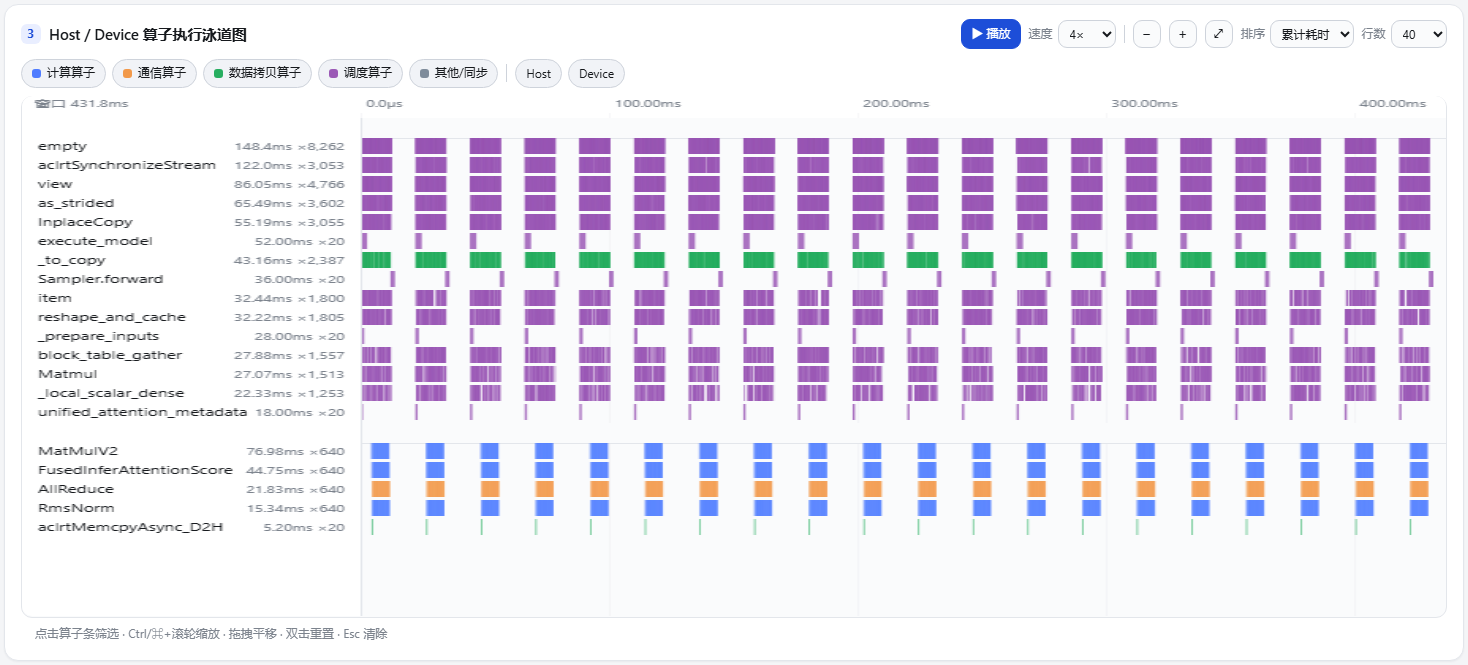
Host(CPU) 与 Device(昇腾 NPU),组内每个算子一行(默认按累计耗时降序,可切换调用次数 / 算子名 / 单次最长,行数可调 20/40/80/160);滚轮滚动行、Ctrl/⌘ + 滚轮以光标为中心缩放(缓动过渡)、Shift + 滚轮或拖拽平移、双击重置、Esc 清除筛选、悬停显示算子卡片(算子名、开始时间、耗时、调用次数、累计/均值/p95、输入输出 shape、OP/Task Type、调用栈、rank/stream)、点击算子条筛选该算子并自动滚动到该行;模块二 · 耗时占比归因(两张图说完全部占比)
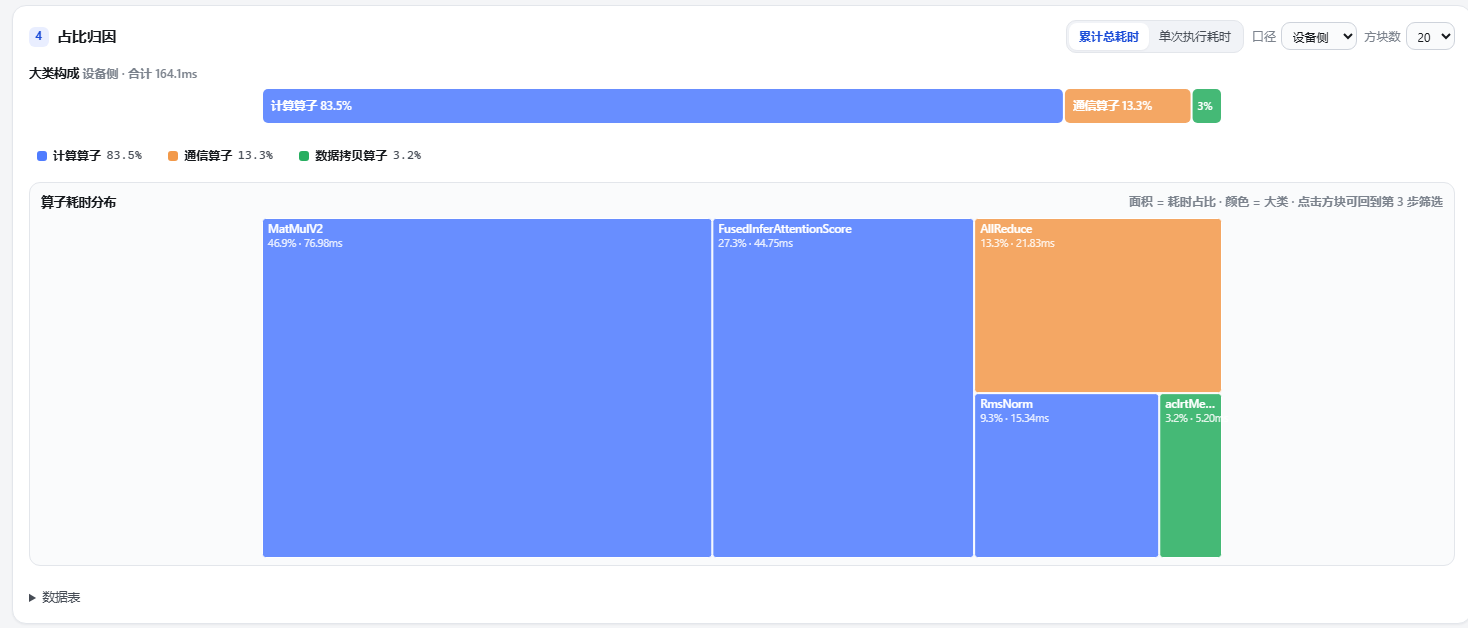
累计总耗时(找"次数多、总量大"的算子)↔ 单次执行耗时(找"单次就很慢"的算子);方块数可调 12/20/30;模块三 · 优化行动(推理链即流程,图上只留数字)
第 5 步把固定的五步推理链做成 ①→⑤ 的流程节点 + 一块图:每个节点只带一个关键数字(瓶颈类型与分数、门限通过项数、机理条数、行动优先级分布、保守收益),点节点切换下方那一块图,文字全部收进「依据」折叠项。
第 6 步 · 优化后导入与前后对比
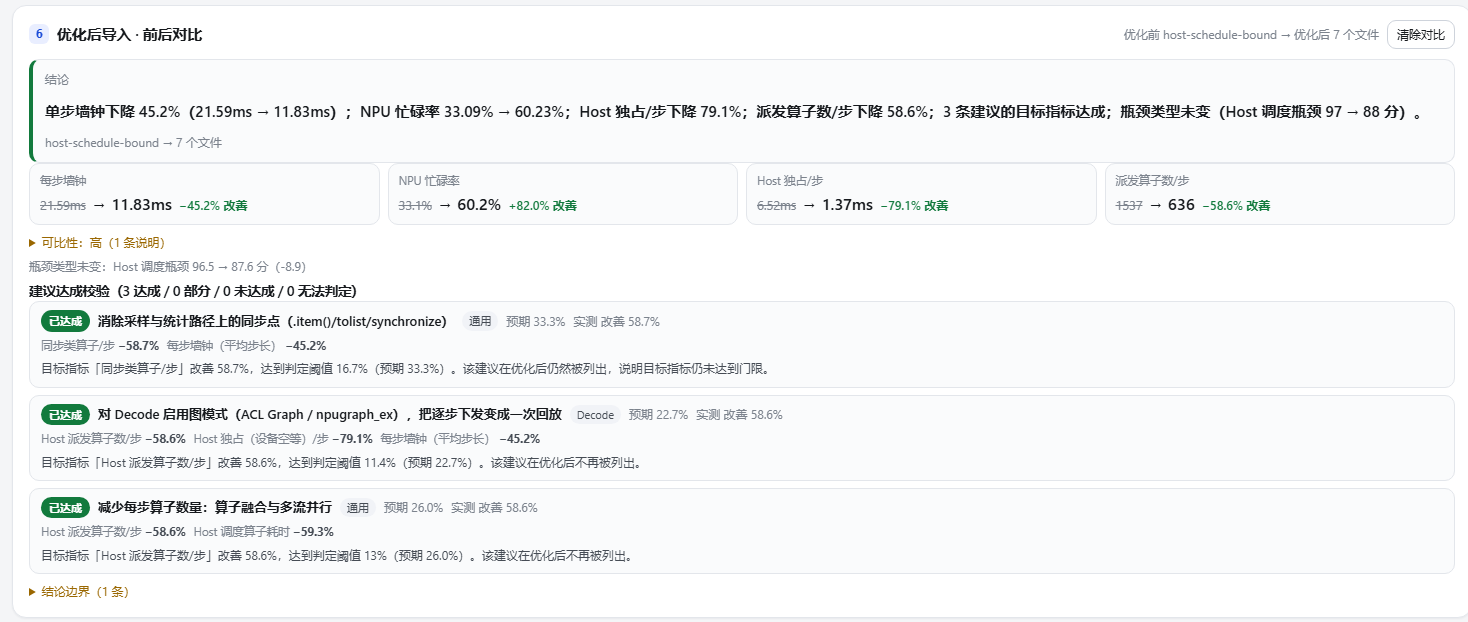
把优化后的那次采集导进来(拖拽 / zip / 按路径,与第 1 步同一套导入方式),页面会自动把当前数据集当作 优化前、新导入的当作 优化后 配对,并回答"改动到底有没有用":
前 → 后 与改善幅度(↑好/↓坏按指标方向判定,占比类指标不会被误判成"变差");已达成 / 部分达成 / 未达成 / 无法判定,并列出目标指标的前后数值与判定阈值(阈值 = 预期收益的一半,下限 1%);配对完成后,第 3 步与第 4 步变成左右对照(左 = 优化前,右 = 优化后):
对比分析在宿主侧完成(lib/analysis/compare.js,接口 GET /api/datasets/<before>/compare?with=<after>),页面只负责摆放,因此同一套判定标准也适用于报告与自动化调用。
第 5 步的 ④ 优化行动里,每条建议右侧都有 「执行」 按钮。点下去不是"打开一个文档",而是把这条建议 变成一份可直接开工的算子优化任务,交给 awesome-ascend-skills 的三个官方安装包执行:
| 安装包 | 在本流程里的角色 |
|---|---|
ascend-base | 环境与设备检查、torch_npu 基础能力(npu-smi、ascend-dmi、torch_npu 等 7 个) |
ascend-profiling | 证据复核与重新采集(profiling-analysis、pytorch-profiling-collection 等 5 个) |
ascend-ops | 算子实现与接入(ascendc、ascend-opplugin、triton-ascend-migration、npu-op-benchmark) |
按下「执行」后宿主侧会(lib/handoff.js):
kernel 取设备计算算子(按累计耗时)、
comm 取通信算子、dispatch / graph 取 Host 下发与同步算子(按调用次数)、copy 取拷贝算子;<project>/.dsh/skills → <project>/.agents/skills → $DSH_HOME/skills → <AGENTS_HOME>/skills)
报告"已安装 / 未安装",缺哪个就给出安装命令,而不是等运行到一半才失败;ADVICE_TARGETS)与同一条阈值规则(预期收益的
一半,下限 1%),列出目标指标的当前值、预期收益与判定阈值;<工作区>/.dsh-vap-tasks/<时间戳>-<建议 id>.md(人读)与 .json(结构化),
页面里可直接复制指令粘贴给会话中的 agent,也可以按任务说明手动执行。因此闭环是:profiling 分析 → 点「执行」→ skills 做算子改造 → 同一负载复采 → 第 6 步对比给出
「已达成 / 部分达成 / 未达成」。接口:POST /api/datasets/<id>/advice/<adviceId>/handoff(未知建议返回 404
并附上可用 id 列表)、GET /api/skills(三个安装包与每个 skill 的可见性)。
端到端实测链路与产物(含必须到昇腾机器执行的部分)见 docs/operator-handoff.md。
动效都用来说清"数据是怎么来的",而不是装饰:载入时 KPI 数字滚动、进度条按阶段推进、泳道图从左到右扫出算子条、treemap 方块按名次依次淡入、收益条从 0 生长、进度条与评分条从 0 增长、面板切换淡入。
localStorage)可一键关闭全部动画;prefers-reduced-motion: reduce 同样会被尊重;aria-pressed、筛选标签);Esc 清除筛选 / 关闭弹窗,流程节点是 role="tab" 的可聚焦按钮(Enter 切换),treemap 方块与大类段可 Tab 聚焦并用 Enter 选中。页面「阶段口径」可切换 自动推断 / 仅 Prefill / 仅 Decode 并重新分析。由于昇腾产物默认没有阶段标签,推荐做法是:
/start_profile → 只发长 prompt → /stop_profile,再单独采 decode),然后在页面上直接指定阶段;step_trace_time.csv 的 Stage 列优先级最高。导出时若图表捕获失败(例如浏览器限制 canvas 导出),报告仍会正常生成,只在图表章节说明原因。
页面顶部「说明文档」按钮,包含:指标定义与计算公式、口径注意事项、每个 profiling 产物(含字段表头)的用途与陷阱、快速开始与性能提示。同样的内容以 Markdown 形式保存在 docs/metrics-and-fields.md。
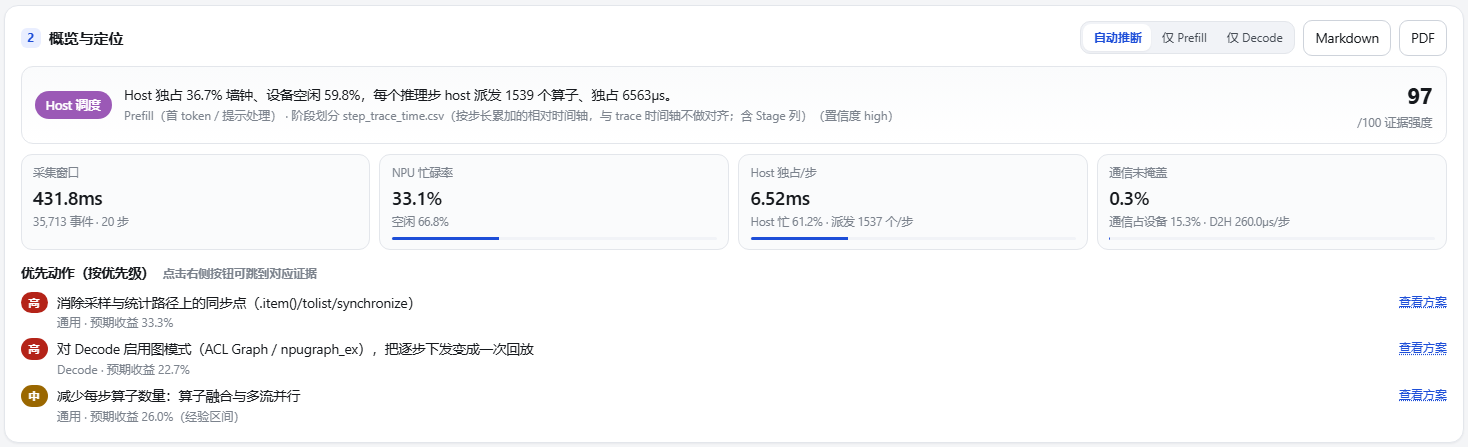
截图由 tools/capture-page.mjs 通过 DevTools 协议驱动无头浏览器生成(等三模块真正渲染、动画结束后再截图)。数据为 test/fixtures/host-schedule-bound 场景:35,713 个事件 / 21 个算子 / 20 个推理步,主导瓶颈 = Host 调度 97 分。
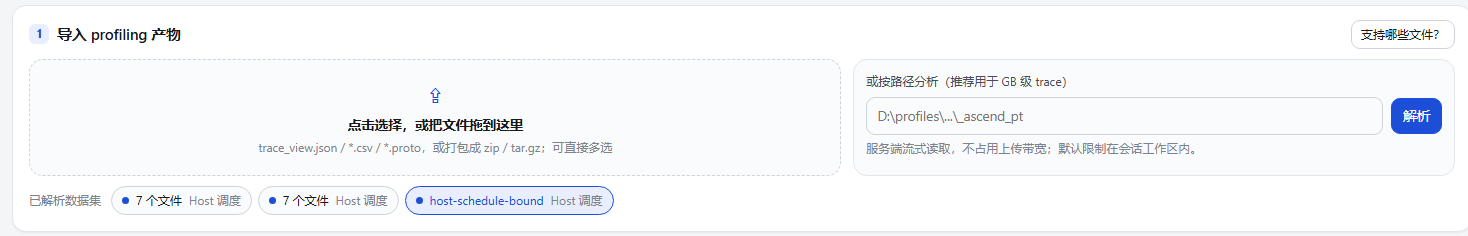
第 1 步 · 导入产物(拖拽上传 / 按路径分析 / 分阶段进度)
第 2 步 · 概览与定位:结论先行 —— 瓶颈横幅 + 四个关键指标 + 三条优先动作(带"查看方案"跳转)
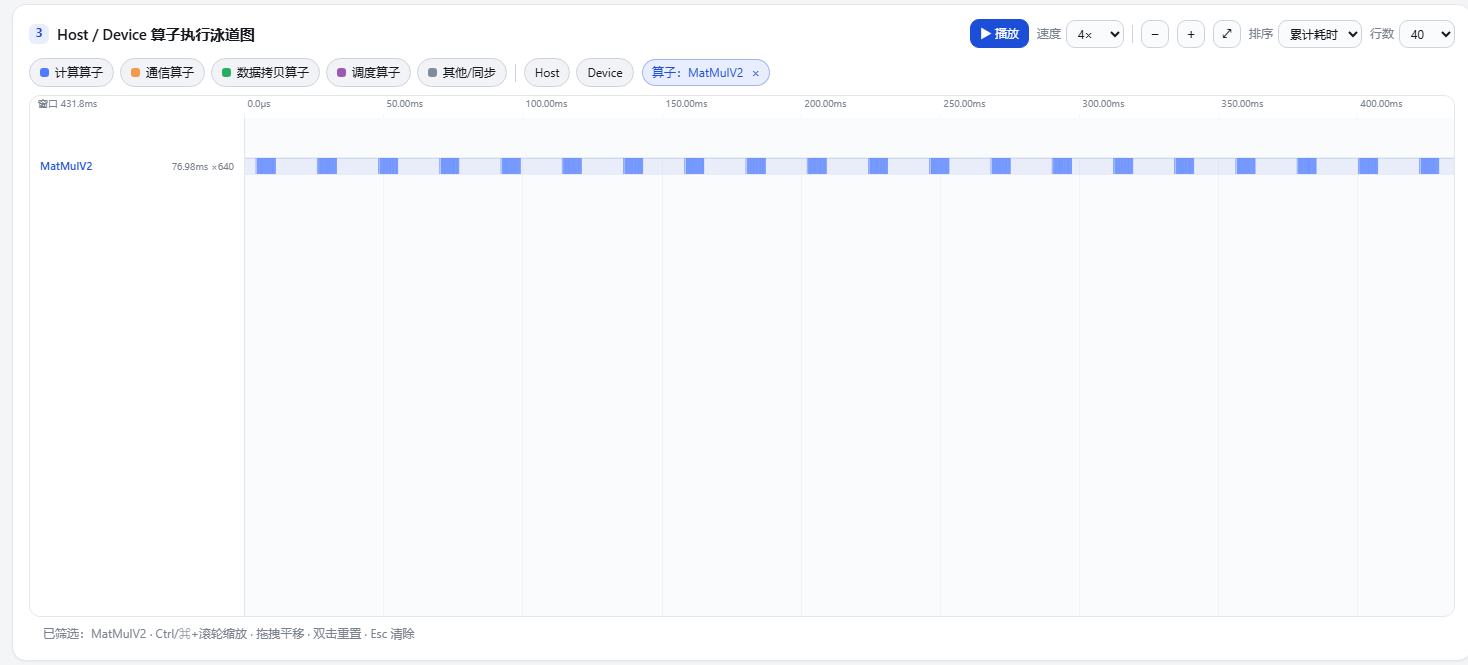
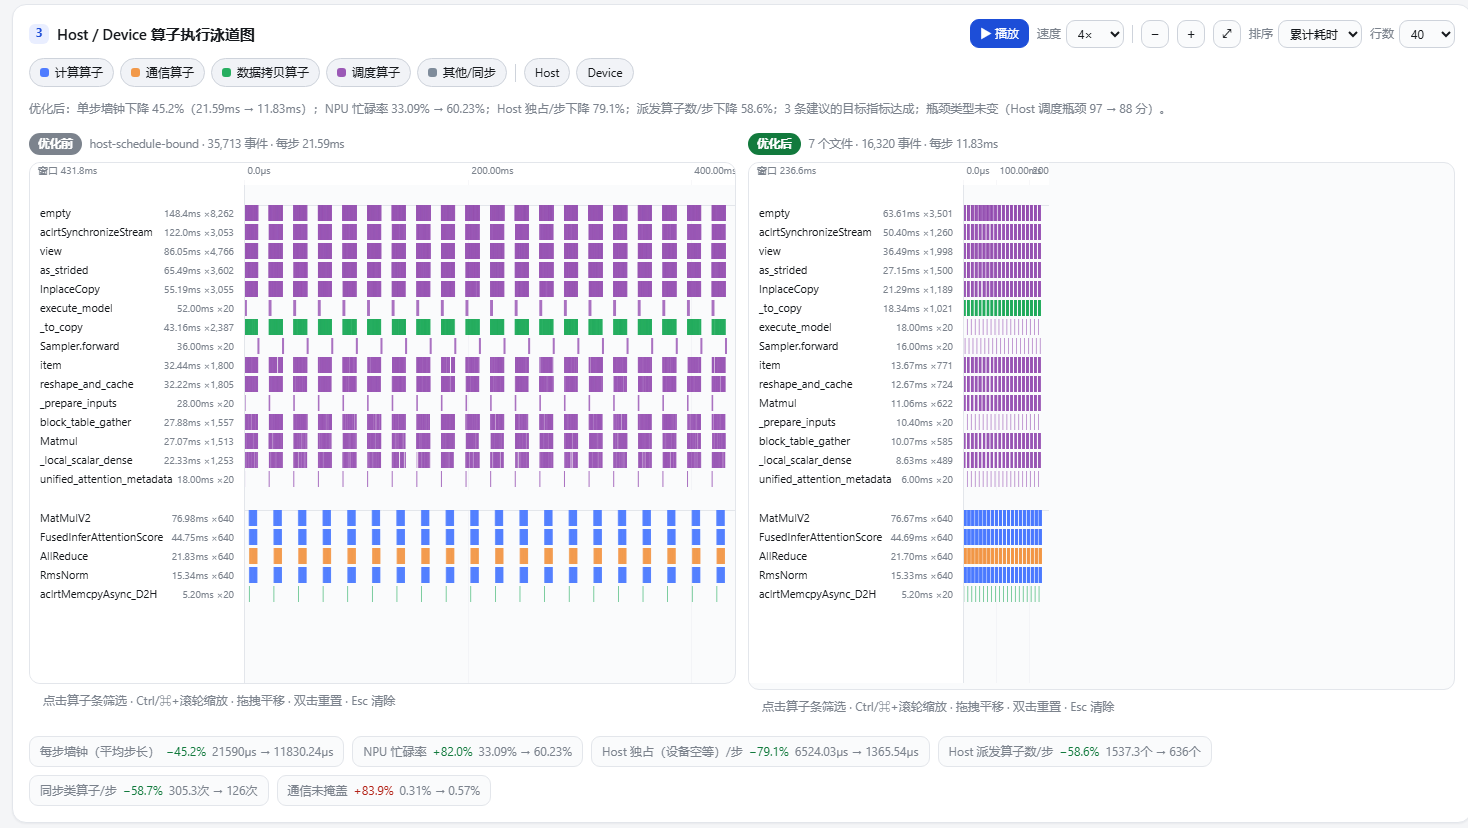
第 3 步 · 时序取证:Host 组(紫=调度、绿=拷贝)与 Device 组(蓝=计算、橙=通信),图例即筛选器,工具栏含播放/缩放/排序/行数
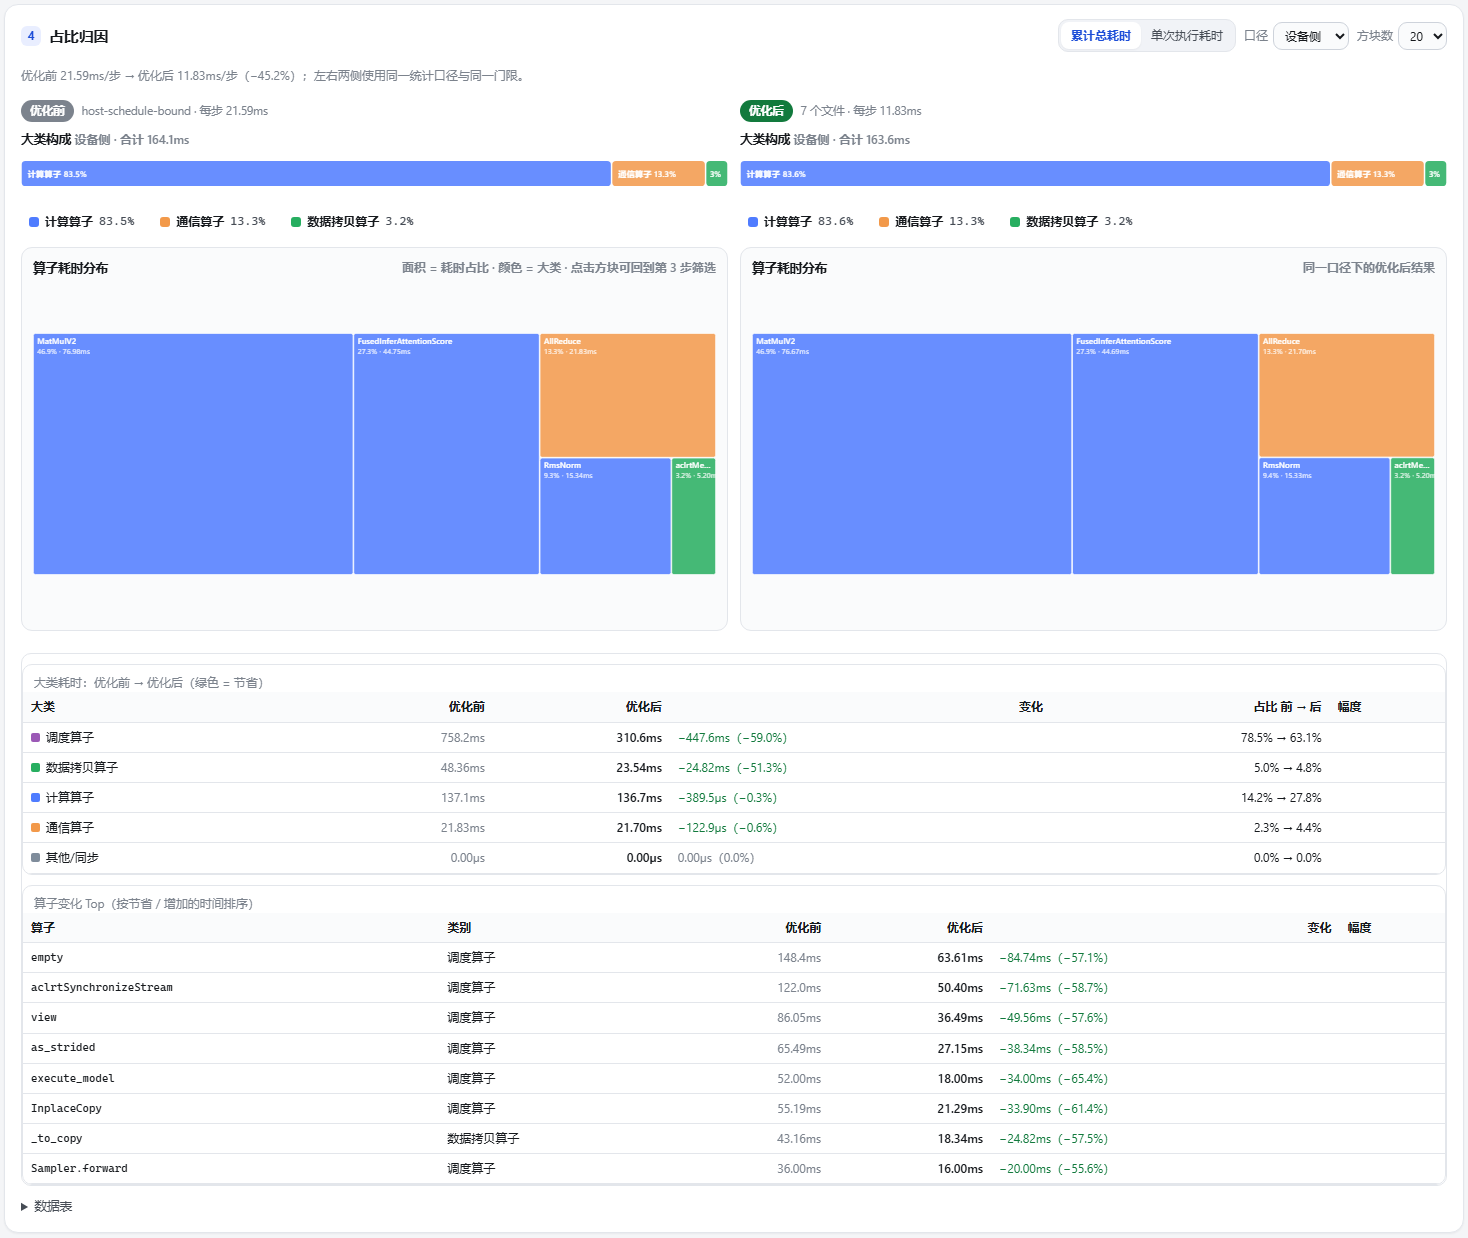
第 4 步 · 占比归因:大类构成条(按大类切开 100%)+ 算子耗时分布图(面积 = 占比、颜色 = 大类)
跨模块联动:点击第 4 步耗时分布图里的 MatMulV2 方块,第 3 步立即筛选到该算子并显示可关闭的筛选标签
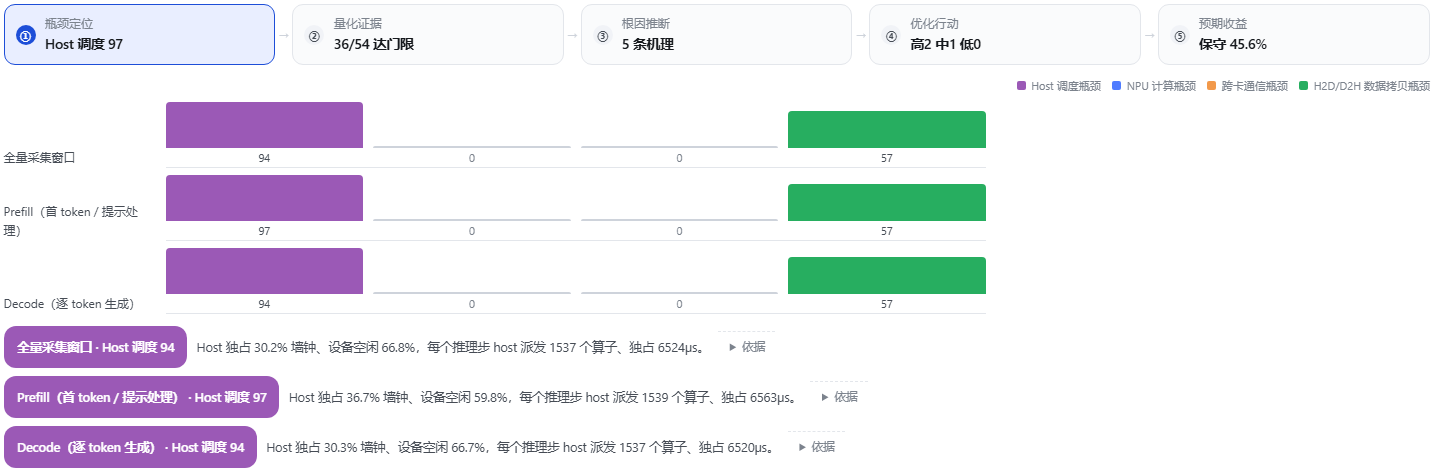
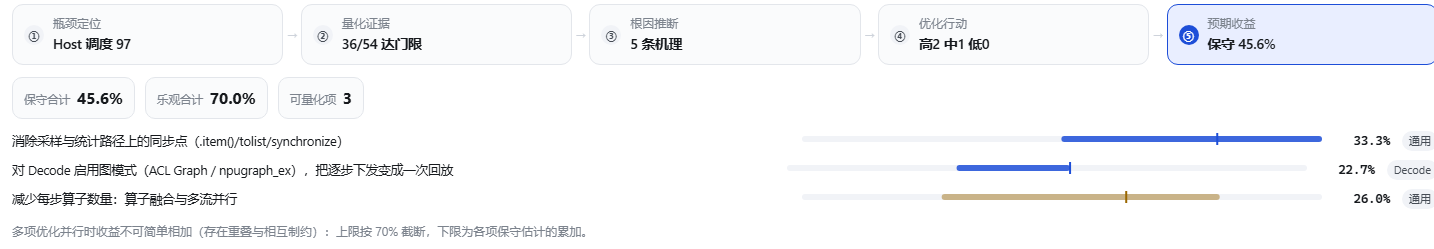
第 5 步 · 优化行动:①→⑤ 流程节点只带一个数字,点节点切换下方图块
① 瓶颈定位:四类候选 × 全量 / Prefill / Decode 打分对比(未达门限的候选显示为 0)
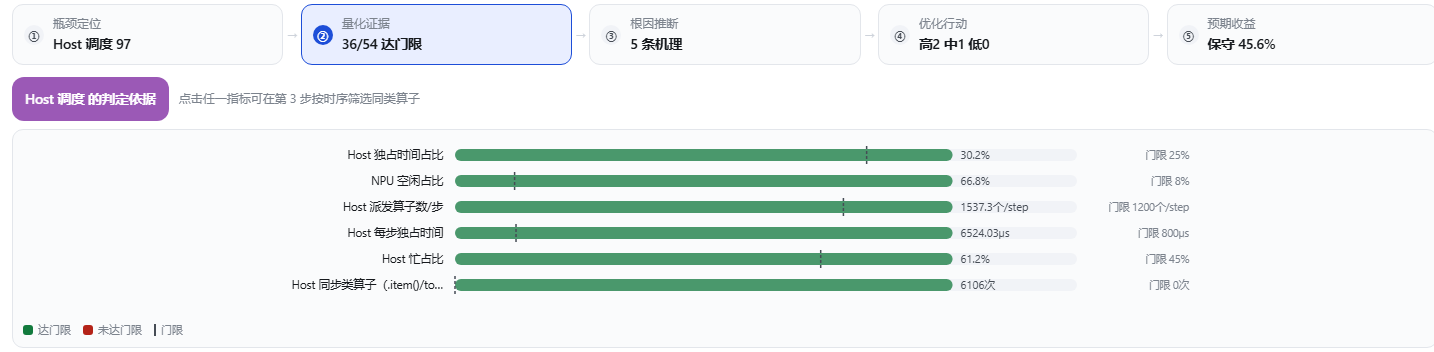
② 量化证据:实测值 vs 门限(绿=达门限、红=未达门限、虚线=门限位置)
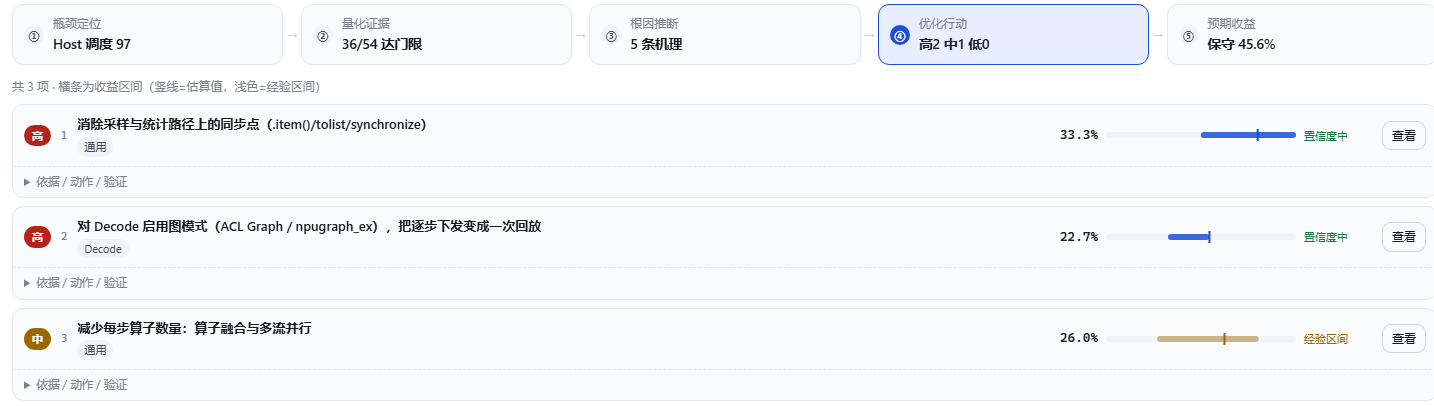
④ 优化行动:每条一眼看到收益区间与置信度,依据 / 动作 / 验证 / 风险收进折叠项
⑤ 预期收益:逐项收益条 + 保守 / 乐观合计
第 6 步 · 优化后导入与前后对比:导入优化后的采集结果后,给出结论句、四张 前 → 后 对比卡、可比性说明,以及第 5 步每条建议的达成校验
第 3 步变成左右两张泳道图(左 = 优化前,右 = 优化后),上方是 delta 徽标
第 4 步变成两条构成条 + 两张耗时分布图,下方是大类与算子的变化表
完整页面长图见 09-full.png(对比模式见 15-compare-full.png),深色主题见 11-dark-share.png。重新生成:
# 1) 启动一个带插件的临时实例(见 §2 方式 C),并让它持有「优化前」数据集(如 host-schedule-bound)
# 2) 启动带调试端口的无头浏览器
msedge --headless=new --disable-gpu --user-data-dir=D:\tmp\edge --remote-debugging-port=9222 about:blank
# 3) 抓图(等待渲染 → 逐区域截图 → 逐步骤截图 → 演示联动筛选 → 导入优化后产物抓前后对比)
node tools/capture-page.mjs --url http://127.0.0.1:3099/vllm-ascend-profiler/ --out docs/screenshots --port 9222 `
  --baseline host-schedule-bound --compare-dir test/fixtures/host-schedule-bound-optimized
--compare-dir必须是绝对路径或可解析到绝对路径:DevTools 交给渲染进程的文件路径只能原样读取,相对路径会得到 0 字节文件并让上传以ERR_ACCESS_DENIED失败(工具内部已做resolve())。
dsh-plugin-vllm-ascend-profiler/
├── package.json                 # 插件声明:main(host 半)+ exports["./client"](browser 半)
│                                #   dsh.bundle.patch → cordis.patch.yml
│                                #   dsh.client { platform: "web" } → 被 dsh-client-modules 发现
├── cordis.patch.yml             # bundle patch:插入 id=vllm-ascend-profiler 的宿主行(含 config)
├── lib/
│   ├── index.js                 # 【宿主插件】路由注册、上传/任务/数据集、报告导出、索引注入
│   ├── client.js                # 【浏览器插件】手写 DSH client module,注册侧边栏入口
│   ├── http.js                  # 有界请求体读取、JSON/静态文件响应、限流日志
│   ├── store.js                 # 任务与数据集的内存存储(TTL + 容量上限)
│   ├── view.js                  # 视图模型投影(事件预算、行预算、契约稳定)
│   ├── docs.js                  # 指标口径 / 产物字段 / 使用说明内容
│   ├── parse/                   # ── 文件解析层
│   │   ├── sniff.js             # 产物识别与校验(证据权重、明确报错)
│   │   ├── archive.js           # zip / tar / gzip 内存解压(有界)
│   │   ├── jsonstream.js        # 流式 JSON 扫描器(裸数组、截断容忍、逐元素回调)
│   │   ├── trace.js             # Chrome trace 解析(Host/Device、B/E/M 事件、单位推断、采样)
│   │   ├── ascendcsv.js         # CANN/torch_npu CSV 解析(表头别名、单位、利用率列)
│   │   ├── csv.js               # CSV 词法(引号、BOM、分隔符、编码回退)
│   │   ├── protobuf.js          # proto/binary 通用 wire 解码 + 字段映射 + 启发式识别
│   │   └── index.js             # 解析编排、目录遍历、进度上报
│   ├── model/                   # ── 数据预处理层
│   │   ├── classify.js          # 算子分类(计算/通信/拷贝/调度)+ 名称归一
│   │   ├── dataset.js           # 数据集构建(泳道、聚合、重叠、空闲、利用率、排名)
│   │   ├── phase.js             # 步骤提取 + Prefill/Decode 归属(含置信度)
│   │   └── stats.js             # 区间并集/重叠、分位数、双峰切分
│   ├── analysis/                # ── 性能分析推理层
│   │   ├── index.js             # 五步链路编排(含阶段作用域与去重)
│   │   ├── bottleneck.js        # ① 定位 + ② 证据(门限打分)
│   │   ├── rootcause.js         # ③ 根因假设(vLLM-Ascend 机理库)
│   │   ├── recommend.js         # ④ 方案 + ⑤ 预期收益
│   │   ├── compare.js           # 前后对比:指标 delta / 大类与算子变化 / 建议达成校验 / 可比性
│   │   └── thresholds.js        # 全部门限常量 + 取值依据
│   ├── handoff.js               # 建议 → 算子优化任务(目标算子 / skills 链 / 验收标准 / 任务包落盘)
│   └── report/
│       ├── markdown.js          # Markdown 报告
│       └── print.js             # 打印/PDF 版 HTML
├── web/                         # 独立可视化页面(原生 Canvas/SVG,无第三方前端依赖)
│   ├── index.html               # 六步流程 + 导入区 + 说明文档
│   ├── styles.css               # 明暗主题(prefers-color-scheme)
│   ├── util.js  api.js          # 工具与 API 客户端(XHR 上传进度)
│   ├── gantt.js                 # 模块一:Canvas 泳道时序图
│   ├── diagram.js               # 图形基元:treemap / 构成条 / 门限对比 / 收益区间 / 推理链 / 根因链
│   ├── charts.js                # 模块二:占比与排行投影 + 数据表 + PNG 导出
│   ├── advice-view.js           # 模块三:①→⑤ 流程 + 单面板图块
│   ├── compare-view.js          # 第 6 步:前后对比面板 / delta 徽标 / 变化表
│   ├── handoff-view.js          # 第 5 步「执行」:算子优化任务面板(算子 / skills / 验收 / 指令)
│   ├── docs-view.js             # 说明文档渲染
│   └── app.js                   # 页面控制器
├── docs/
│   ├── metrics-and-fields.md    # 指标含义 + profiling 字段说明
│   ├── analysis-logic.md        # 分析推理链、门限表、收益推算公式、前后对比判定规则
│   ├── operator-handoff.md      # 端到端交接:profiling 分析 → 算子 skills → 算子工程(含实测链路)
│   ├── research/                # 产物格式调研(带官方文档/源码引用)
│   └── screenshots/             # 界面截图
├── tools/capture-page.mjs       # 开发工具:DevTools 协议驱动无头浏览器抓图
└── test/                        # 107 个用例 + 场景夹具生成器 + 真实 trace 夹具
上传/路径 → 解压展开 → sniff 识别校验(不合格直接明确报错)
        → trace/CSV/proto 解析(流式 + 采样,进度上报)
        → buildDataset(分类、归一、泳道、聚合、阶段、重叠、空闲、利用率)
        → analyzeDataset(① 定位 ② 证据 ③ 根因 ④ 方案 ⑤ 收益)
        → buildViewModel(事件/行预算投影)→ 页面三模块
        → 报告导出(Markdown / 打印 HTML)
cordis.patch.yml 插入 id: vllm-ascend-profiler,inject: ['webServer'] 后注册一个前缀路由 /vllm-ascend-profiler,其下再分发页面、静态资源与 API;package.json 的 dsh.client + exports["./client"],被 @deepseek-ai/dsh-client-modules 扫描进 window.__DSH_BOOT__,通过 /plugins/<id>/client.js 提供;宿主半还会向 shell 注入 __VLLM_ASCEND_PROFILER__ 全局,因此浏览器半无需重复配置路由前缀;ctx.slots 缺失/异常做了保护——即使未来 shell 移除该插槽,也只会打印一条告警,不会导致浏览器启动失败;cordis.patch.yml 注释):路由前缀、上传/内存上限、事件与行预算、数据集容量与 TTL、是否允许按路径分析、是否允许工作区外路径、峰值算力(把 FLOPs 换算成算力利用率)、proto 字段号映射(protoFieldMap)、多 rank 对齐方式、TopN、门限覆盖。| 产物 | 产出方 | 用途 |
|---|---|---|
trace_view.json | torch_npu Ascend PyTorch Profiler | 泳道图与事件级聚合(Host + Device) |
kernel_details.csv | torch_npu | 设备侧 kernel 明细 + AI Core 流水指标(mac/mte*_ratio) |
operator_details.csv | torch_npu | Host/Device 双侧算子耗时(Self/Total) |
op_statistic.csv | torch_npu / msprof-analyze | 算子聚合统计(交叉校验) |
op_summary*.csv | msprof / MindStudio | 算子实例明细(Task Type / Accelerator Core / Block Num) |
step_trace_time.csv | torch_npu | 逐步 Computing/Communication/Free 分解 + Stage 阶段列 |
api_statistic.csv | torch_npu / msprof-analyze | Host API 统计(计入 Host 调度开销) |
communication.json / communication_matrix.json | msprof-analyze | 集合通信统计与矩阵 |
profiler_info_{Rank}.json | torch_npu | 采集元数据(设备、rank、并行、版本) |
*.proto / *.bin | CANN | 通用 wire 解码 + 启发式事件提取(置信度低,可用 protoFieldMap 精确映射);未分帧的连续记录只提取首个可识别记录并明确告警 |
analysis.db / msprof_*.db | torch_npu / msprof | 不直接解析,提示用 msprof-analyze 导出 CSV |
.zip / .tar.gz | 用户打包 | 内存内展开,成员大小与数量有上限 |
不兼容文件会给出明确报错(而不是空白图表),例如:
文件证据不足以判定为 vLLM-Ascend profiling 产物(累计证据权重 2 < 4)。
期望的产物包括:torch_npu 的 trace_view.json、kernel_details.csv、operator_details.csv、op_statistic.csv,
或 msprof 的 op_summary.csv / step_trace_time.csv,或上述文件所在的 *_ascend_pt 目录。
node test/make-fixture.mjs      # 生成三个场景夹具(decode 通信受限 / prefill 计算受限 / Host 调度受限)
node test/all.test.mjs          # 运行全部用例(单进程,避免沙箱下的进程派生限制)
# 或分文件运行:
node test/parse-primitives.test.mjs   # CSV 词法 + 流式 JSON 扫描器 + 分类优先级
node test/protobuf.test.mjs           # proto wire 解码、字段映射、启发式识别与降级
node test/pipeline.test.mjs           # 真实 Ascend trace 片段(裸数组 + 十进制字符串 ts + 截断文件)
node test/analysis.test.mjs           # 三种瓶颈场景的定位/根因/方案/收益 + 报告渲染
node test/http.test.mjs               # 宿主 API 全流程(上传、路径、进度、导出、校验失败、越权、图表快照)
node test/web-dom.test.mjs            # 前端三模块真实渲染 + 控制器 init + CSS/ID 一致性
node test/client-bundle.test.mjs      # 浏览器插件包的加载、注册与降级
当前状态:107 个用例全部通过(CI 在 Node 22 与 24 上跑同一套,见 .github/workflows/test.yml)。
值得说明的验证强度:
test/fixtures/README.md),而不是全靠自造数据;init() 与三个渲染器——这套测试在开发中抓到了"控制器缓存了不存在的元素 id 导致整页不渲染""中文类名导致建议卡片退化成未知元素"这类只有真实渲染才会暴露的问题;__DSH_BOOT__ 并从 /plugins/??<id>/client.js 成功加载,宿主注入的 __VLLM_ASCEND_PROFILER__ 出现在 shell 索引中;POST /api/jobs(按路径)解析 35,713 事件 → 报告导出 Markdown 43KB + 打印版 52KB(含图表快照)。tools/audit-provenance.mjs 用一个已启动的实例 + 无头浏览器回答这个问题,28 项检查分三层:
# 1) 启动带插件的实例(§2),2) 启动带调试端口的无头浏览器(§3.10)
node tools/audit-provenance.mjs --url http://127.0.0.1:3099/vllm-ascend-profiler/ `
  --fixture test/fixtures/host-schedule-bound --port 9222
POST /api/jobs 收集 → 分文件上传 → /start)解析真实产物,然后用独立写的 CSV 解析器重新求和 op_statistic.csv / kernel_details.csv,与页面数据逐算子比对(实测偏差 0.0000%);同时校验文件血缘(每个文件的识别证据)、"大类 = 该大类算子之和"、占比合计 100%、证据指标与 KPI 同源、泳道行与事件全部来自产物;trace_view.json 中 640 条 MatMulV2 事件翻倍)后重新上传,要求数字跟着变 —— 累计耗时 ×2.000、computeUs 增量与产物增量完全相等、候选证据按新数据重算;再单独改 CSV,验证"以 trace 为准 + 暴露 cross-check 偏差";最近一次结果:28/28 通过(三个场景数据集在页面上给出三套不同的构成条 / 分布图 / 推理链)。
step_trace_time.csv 的 Stage 除外)。未分开采集时,阶段划分为推断结果,报告中标注置信度;建议按 §3.7 分开采集。op_statistic.csv(按算子)、kernel_details.csv(按 kernel)与 operator_details.csv(按算子实例)里。插件只取其中一张表作为 CSV 口径(优先统计表),其余表作为证据列出;两张表相差 >20% 时告警,而不是把差异平均掉或相加。Start Time 是设备绝对时间,trace 的 ts 是相对时间,二者不做同轴绘制;聚合按统一单位合并并给出 cross-check 偏差。protoFieldMap 精确指定字段号。127.0.0.1,因此仅本机可访问;若把 --host 暴露到网络,请自行加访问控制。docs/metrics-and-fields.md — 指标含义、计算公式、口径边界,以及每个 profiling 产物的字段说明docs/analysis-logic.md — 五步推理链、全部门限取值依据、收益推算公式、如何提高结论可信度docs/research/ascend-profiling-artifact-formats.md — 两类产物(Ascend PyTorch Profiler 与原生 msprof)的目录与文件清单、CSV 表头、trace 结构、陷阱docs/research/hccl-memcpy-profiling-report.md — HCCL 通信与 memcpy 的算子命名、Task Type 取值、字段级参考docs/research/hccl-research-notes.md — 上述结论的原始调研记录(含源码位置)test/fixtures/README.md — 测试夹具的来源与第三方素材授权说明MIT,见 LICENSE。运行时不打包任何第三方代码(零依赖,只用 Node 内置模块与浏览器原生 API);仓库内仅有一份第三方测试夹具(来自 Apache-2.0 的 Ascend/mstt),来源与授权说明见 THIRD-PARTY-NOTICES.md。
DeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
把回答做成一页可视化 HTML:模型只写简短的 Markdown 草稿,随包附带的 `am` 命令行生成页面,支持流程图、时序图、树、时间线、ER 图、表格和提示框。
在 dsh 里装上这个插件即可,无需登录、注册或填 API Key,就能使用包括 Muse Spark 1.3、MiMo V2.6 在内的前沿模型——完全免费,不限量。 All you do is install this plugin in dsh: no login, no sign-up, no API key — the frontier models are just there, Muse Spark 1.3 and MiMo V2.6 among them. Completely free, with no usage cap.

