

dsh-web
zhu1090093659/dsh-webDeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
群太多,重要的那条总是被淹掉。
一天没看手机,四百条未读里就是三条跟你有关:一条选课通知、一条提交截止、一条你被 @ 了。 剩下的全是"哈哈哈哈"和表情包。
QQreminder 就是干这个的:把"我该知道的"从"我错过的"里挑出来。
给 DeepSeek Harness 用的插件。 全程本地、只读、不登录、不联网上传。
QQ 本地数据库 ──▶ 建索引 ──▶ 按「你的关注词」多信号打分 ──▶ AI 精排 ──▶ 可点击的 HTML 报告
      ▲            │              │                          │
   (解密那一步    │        本地规则只负责"召回"         真正理解内容、
    不在本插件内,  │        (快、免费、能离线)          适应任何行业
    见下文方式 C)  │
                  └────────── 全程本地 · 只读 · 不登录 · 不上传 ──────────┘
一句话分工:本地脚本负责"把可疑的都捞出来",AI 负责"到底哪条重要"。
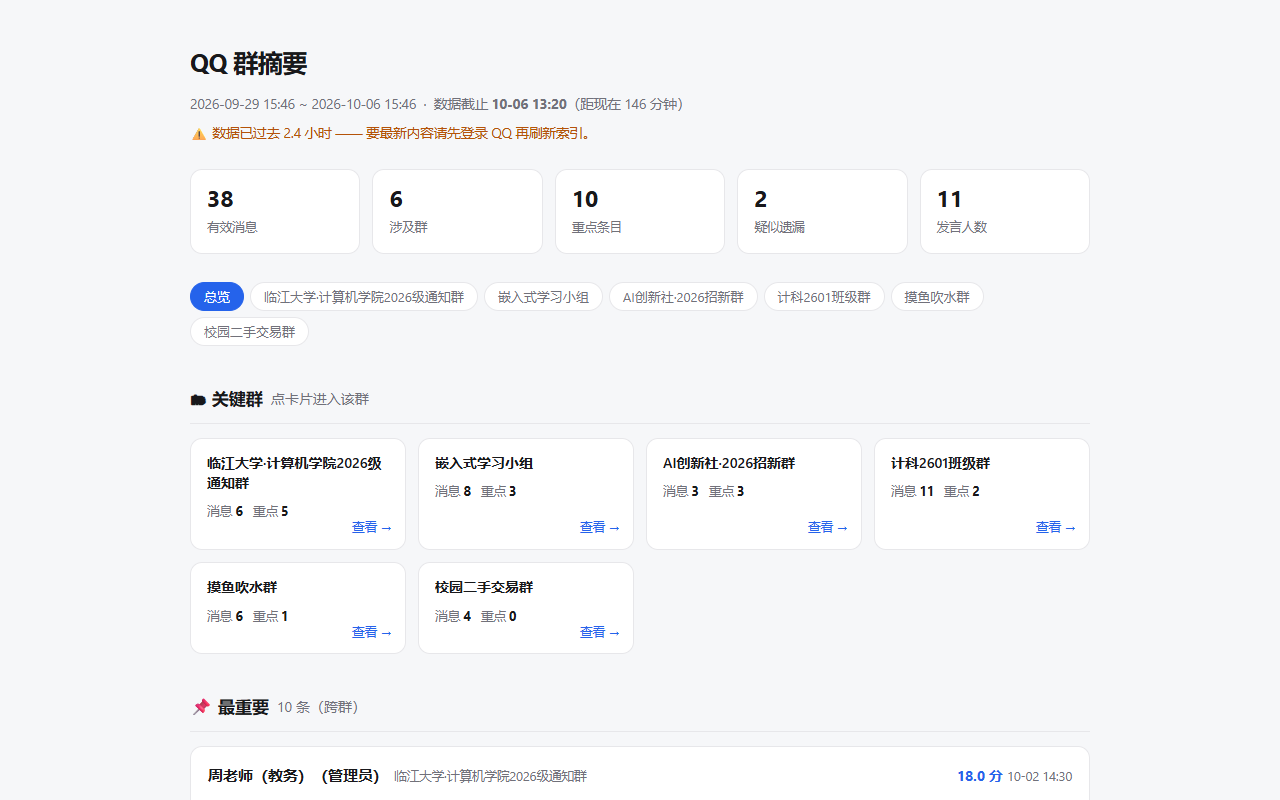
(下面两张都是真截图,数据是插件自带的虚构示例)
点进某个群,只看这个群:
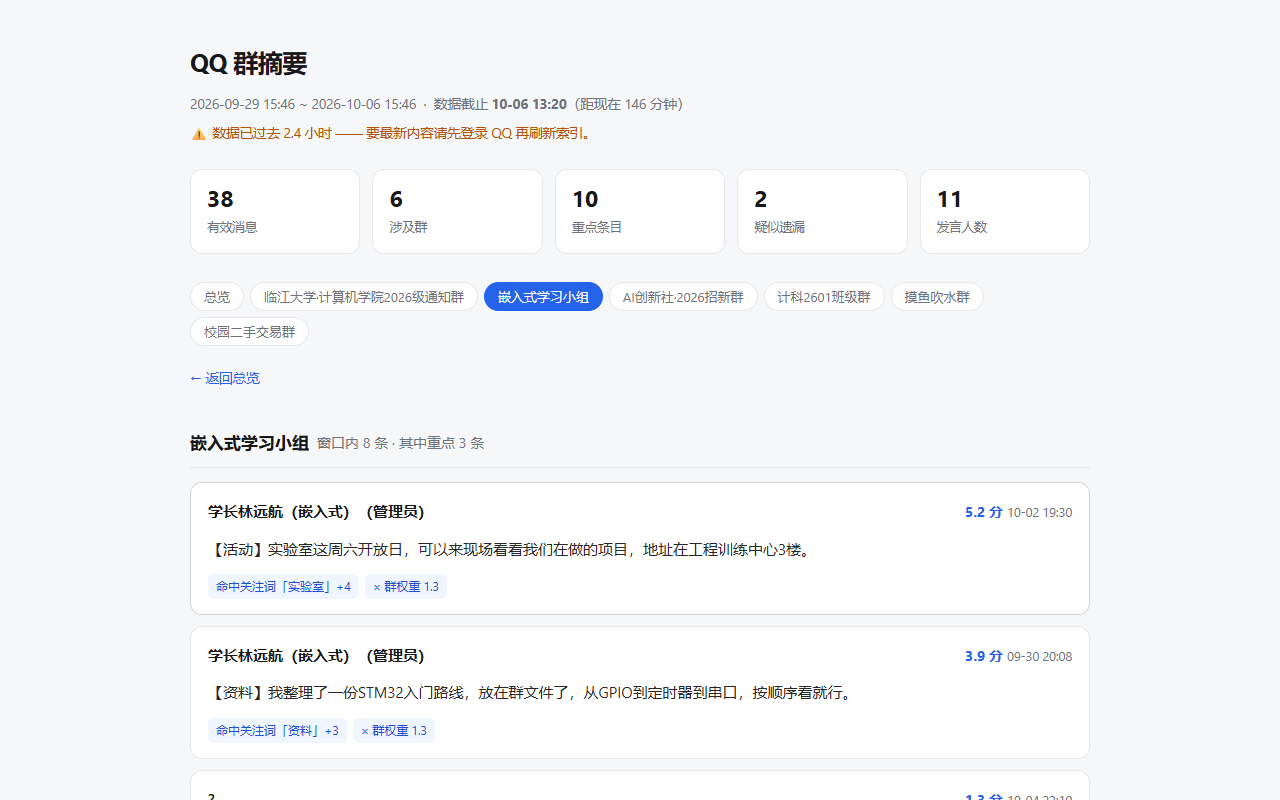
顶部页签、群卡片、消息分布条 —— 三个入口都能进群,怎么顺手怎么点。
💡 截图顶部那行橙色提示「数据已过去 2.4 小时」不是 bug,是故意的: 它读的是本地数据库文件的最后写入时间。QQ 没开、没登录过,它就冻在那儿 —— 插件会如实告诉你数据有多新,绝不拿旧数据当实时。
| 功能 | 说明 | 入口 |
|---|---|---|
| 可点击 HTML 报告 | 五个数字 + 群卡片 + 「为什么重要」+ 「你可能漏了」 | 面板 / 让 AI 生成 |
| 群内下钻 | 点群卡片 / 页签 / 分布条都能进群 | 报告页 |
| 话题检索 | 「帮我找群里关于 X 的信息」,带上下文,不是孤零零一条 | 对 AI 说 |
| 关注词画像 | focus.json 一改,什么叫"重要"就变 | 面板 / 配置文件 |
| AI 冷启动分析 | 第一次用:本地只做客观统计+抽样,把材料交给 AI 判断该盯哪些群 | 面板【✨ 用 AI 分析】 |
| 示例数据 | 零配置试玩(人物群名全虚构) | 面板【📦 加载示例数据】 |
| 授权开关 | 读不读正文,控制权在你手上 | 面板开关 |
| 数据新鲜度声明 | 每次输出都写"数据截止几点",不含糊 | 报告 / 摘要 |
① 装插件(下面有安装命令)
② 打开 DSH → 设置 → QQreminder
③ 第一次没有数据?点【📦 加载示例数据】
   → 立刻生成一份虚构的大学群聊,看看它到底能干嘛
示例数据是虚构的(临江大学 / 刘老师 / 周老师……),人名群名对话全是编的,随便看随便截图。
这个插件自带技能和工具,所以 AI 装上就知道它能干什么:
「翻一下群,看看今天有什么重要的」
「帮我找群里关于选课的所有信息」
「有没有我漏掉的?」
AI 会自己调 qq_search / qq_digest,不需要你记任何命令。
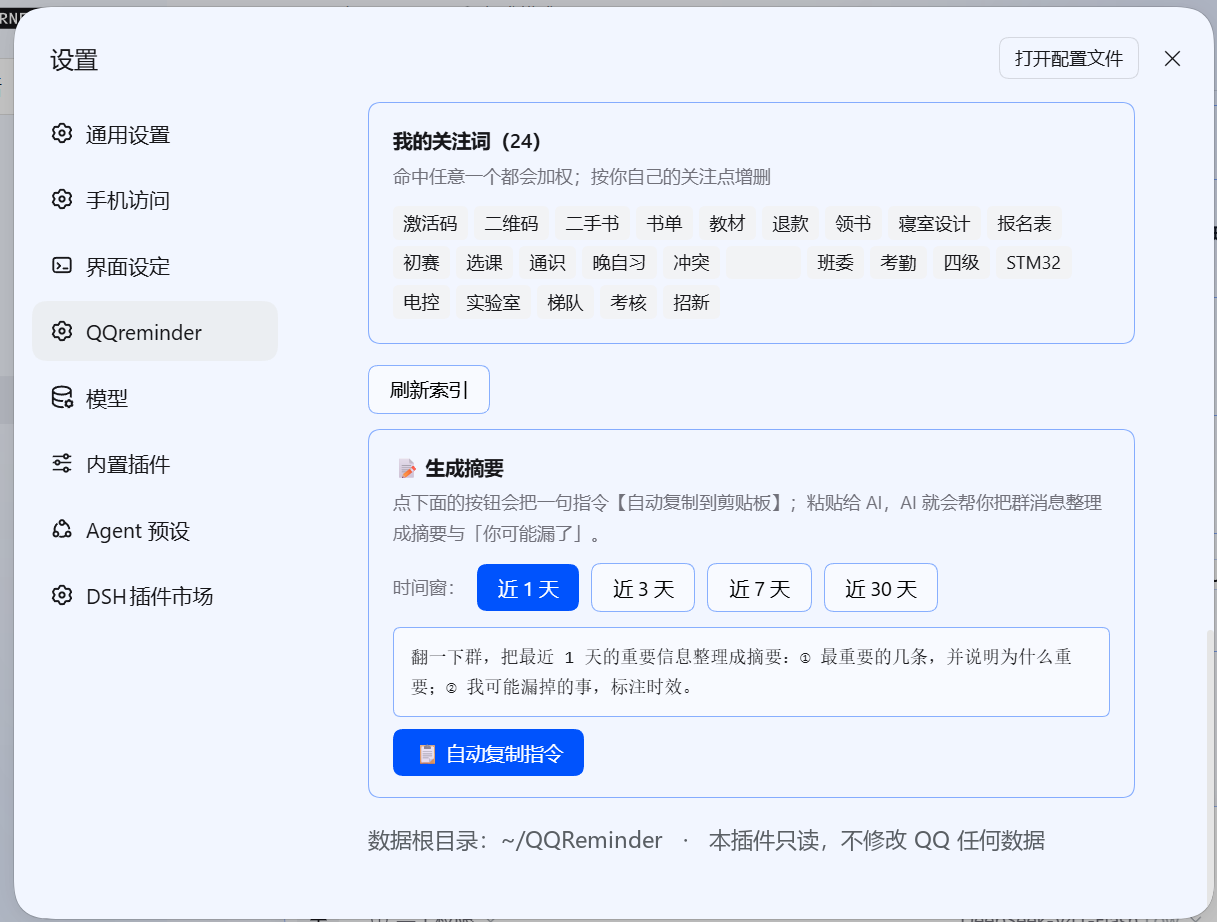
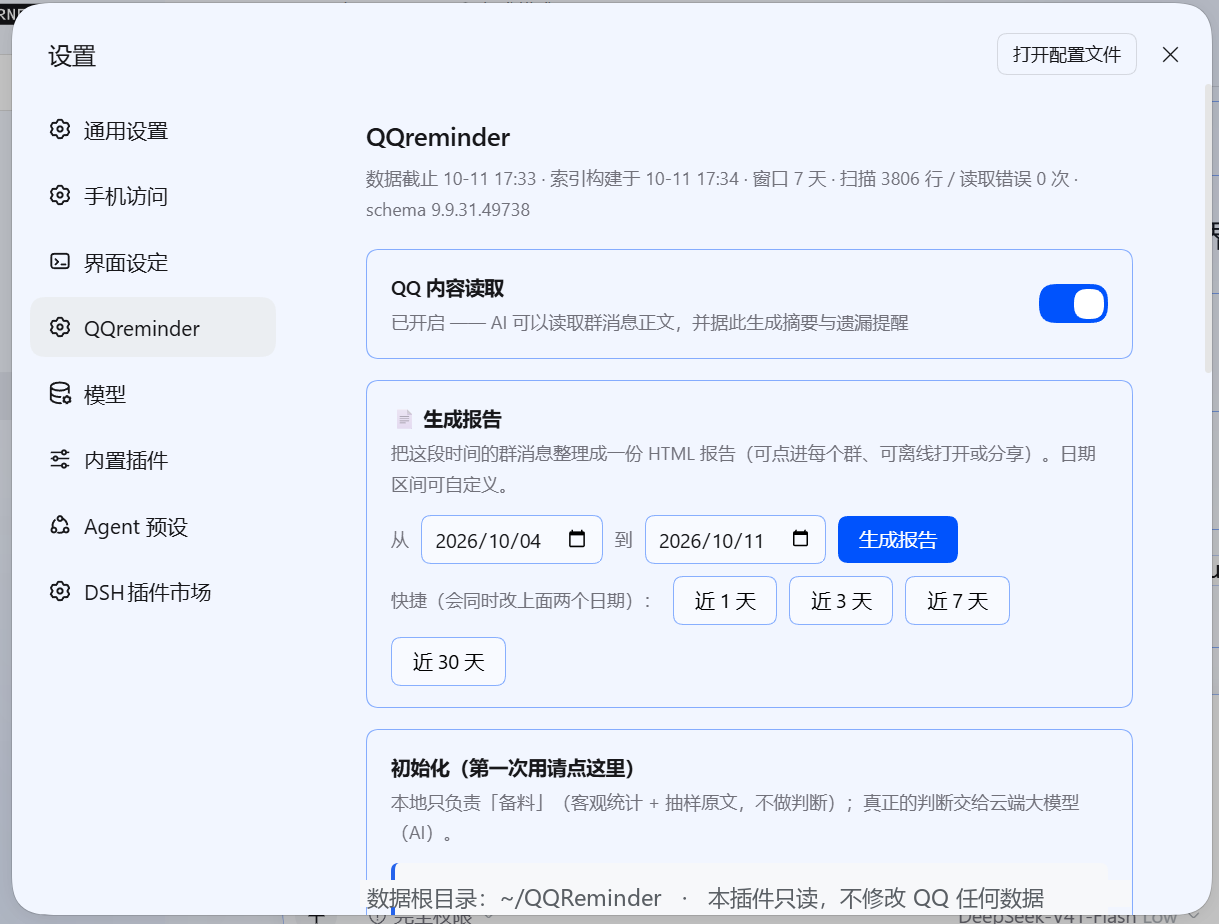
面板上还有两个按钮:
| 按钮 | 做什么 |
|---|---|
| 📄 生成报告 | 选个日期区间 → 出一份上面的 HTML 报告 |
| 📝 生成摘要 | 把一句指令自动复制到剪贴板 → 粘给 AI |
| ✨ 用 AI 分析 | 第一次用时帮你分析该盯哪些群、该关注什么词 |
⚠️ 面板上写清楚了哪个按钮会改配置:只有「应用选中」才会写。 其他按钮都只是准备材料,不会偷偷动你的东西。
# 从 GitHub 装(需要 DSH 0.2.0+)
dsh plugin add https://github.com/K9m1a5c/dsh-qqreminder
或者本地打包:
git clone https://github.com/K9m1a5c/dsh-qqreminder
cd dsh-qqreminder
npm pack
dsh plugin add dsh-qqreminder-*.tgz
依赖:只要 Python 3.8+(引擎全部用标准库,不需要 pip install 任何东西)。
插件会自动找 python3 / python / py,找不到会在面板里告诉你。
QQreminder 是分析层,它需要一个已经建好的本地索引才能工作。
点面板上的【📦 加载示例数据】,它会生成一份虚构数据放进你的数据目录。 零配置、零风险,用来试试功能、看看报告长什么样。
本仓库不包含解密模块,也不提供任何绕过 QQ 加密的代码。 你需要自己准备好数据,然后在数据目录下建一份 SQLite 索引:
<数据目录>/                          # 默认 ~/QQreminder,可用环境变量 QQREMINDER_ROOT 改
└── qgd/
    ├── data/index.db                # 索引(表结构见下)
    ├── focus.json                   # 你的配置:监工群 / 关注词 / 打分规则
    └── authorization.json           # 授权开关:{"qq_read": true}
index.db 需要的三张表:
-- 消息(核心)
messages(msg_id INTEGER PRIMARY KEY, ts INTEGER, day TEXT, hour INTEGER,
         group_code TEXT, group_name TEXT, sender_uid TEXT, sender_qq TEXT,
         sender_name TEXT, direction TEXT, msg_type INTEGER, subtype INTEGER,
         kind TEXT, text TEXT, reply_seq INTEGER)

-- 群
groups(group_code TEXT PRIMARY KEY, group_name TEXT, weight REAL,
       msg_count INTEGER, last_ts INTEGER)

-- 元信息(至少要 cutoff_ts,报告会如实声明数据截止时间)
meta(key TEXT PRIMARY KEY, value TEXT)   -- cutoff_ts / built_at / read_errors ...
engine/load_example.py 就是照着这个结构写数据的,可以直接当参考实现看。
QQreminder 只做分析。「从 QQ 数据库提取消息」这一步不在本插件范围内 —— 本仓库不包含任何解密代码。
如果你需要那一步,社区里有专门做这件事的开源项目:
| 项目 | 用途 |
|---|---|
| QQBackup/QQDecrypt | 解密 QQ 本地数据库 |
| QQBackup/nt_msg_db_util | 消息数据库解析工具 |
| NapNeko/qq_dump_db | 导出 QQ 数据库 |
拿到解密后的数据,按上面「方式 B」的表结构整理成 index.db,本插件就能用。
⚠️ 这些工具与本项目没有任何关联。 它们涉及处理 QQ 的加密数据库, 可能包含逆向工程相关内容 —— 请自行评估合规性与风险。 本项目不为其行为负责,也不提供相关技术支持。
装好插件,直接对你的 AI 说:
"我的 QQ 群消息太多了,帮我整理一下。如果我没有数据,告诉我怎么弄。"
AI 会读插件自带的说明(assets/qqreminder.md),然后带你走完:
① 告诉你去哪拿一个【已经解密的】QQ 消息数据库
      (解密不在本插件范围内,它会指路并说明风险)
② 你拿到文件之后,把路径告诉它
③ 它自己探索那个库的结构,写转换、生成 index.db
④ 然后就能出报告 / 摘要 / 话题检索了
⭐ 说明书就在插件里 —— 装上之后,AI 自己就知道该怎么做,你不用研究任何格式。
这也是本插件唯一"需要用户配合"的一步:拿到明文数据库。 除此之外全程由 AI 完成。
focus.json{
"监工群": [ { "群号": "…", "群名": "…", "权重": 2.0 } ],
"关注词": { "截止": 6, "报名": 5, "选课": 6 }, // 命中即加权
"降权词": { "抽奖": -3, "优惠": -3 },
"身份词": ["老师", "班助", "学长"], // 名片里带这些 = 可信来源
"通知词": { "强": ["通知", "全体成员", "务必"], "弱": ["提醒", "安排"] },
"遗漏提示词": { "时效": ["截止", "之前"], "行动": ["报名", "提交"] },
"打分": { "遗漏区间": [2, 6], "过期天数": 2 }
}
「关注词」是你可以随便改的地方 —— 学生写"选课/保研",上班族写"需求变更/报销/周会", 改成你自己的词,它就开始替你干活。
打分是多信号加权,不是数关键词:
| 信号 | 分值 | 为什么 |
|---|---|---|
| 命中关注词 | +6 | 你最在意的,优先 |
| @我 | +5 | 点你名了,基本跑不掉 |
| 群主 / 管理员发的 | +4 | 权威来源 |
| 名片含身份词(老师/班助/学长) | +3 | 同上 |
| 通知类强词 / 弱词 | +3 / +1 | 「务必」「全体成员」vs「提醒」 |
| 长文 | +1 ~ +2 | 通知往往写得长 |
| 转发 | +1 | 常是"帮转一下"的重要事 |
| × 群权重 | ×0.4 ~ ×2.0 | 摸鱼群的事再热闹也不该顶掉班群 |
外加一层**「你可能漏了」:分数中等(2~6)但含时效 / 行动 / 疑问词的消息 —— 这类最容易被"群消息太多"淹没,超过 2 天还会标已过期**。
本地规则永远追不上行业差异 —— 学生关心「选课」,上班族关心「报销」,本地词表写不完。
所以这里分两层:
本地脚本 = 召回(快、免费、离线可用,负责把可疑的都捞出来)
AI       = 精排(真正理解内容,适应任何行业)
面板上的【✨ 用 AI 分析】就是这个思路:本地只做客观统计和抽样, 把材料交给 AI,由它判断"哪些群值得盯、该关注什么词"。
隐私:所有分析都在本机完成。唯一会"出去"的,是你在对话里主动交给 AI 的内容 (比如点【用 AI 分析】后把材料发出去)—— 这一步由你决定。
面板上有一个 「QQ 内容读取」 开关,对应 authorization.json 里的 qq_read:
这是给你(而不是给程序)的控制权:随时可撤销。
Q:需要登录 QQ 吗? A:不需要。它读的是本机数据库文件,不登录、不碰协议、不连腾讯服务器。
Q:会把我的聊天记录上传吗? A:不会。所有分析在本机完成。唯一"出去"的是你主动粘给 AI 的材料(比如点了【用 AI 分析】)。
Q:手机 QQ / 微信 / TIM 能用吗? A:目前不能,只支持本机 PC 版 QQ 的数据库。
Q:索引多久更新一次? A:手动。点面板【刷新索引】,或让 AI 跑一次;它不会背着你在后台扫描。
Q:没装 Python 会怎样?
A:面板会明确告诉你"没找到 Python",并列出它找过的命令(python3 / python / py)。
装一个 3.8+ 即可,不需要 pip install 任何东西。
Q:为什么报告顶部写着"数据已过去 2.4 小时"? A:那是故意的。数据有多新就说多新,不拿旧数据冒充实时。
想做的、待讨论的都会开成 Issue 挂在那边 —— 有想法欢迎去留言:
还有别的想法?直接开 Issue 就行。
dsh-qqreminder/
├── lib/
│   ├── index.js              # 宿主侧:12 个 HTTP 端点 + 自带技能 + 2 个 AI 工具
│   └── client.js             # 面板:设置页里的「QQreminder」
├── assets/qqreminder.md      # 自带技能(AI 的操作手册)
├── engine/                   # ★ 分析引擎(纯 Python 标准库)
│   ├── score.py              # 多信号打分 → 摘要 + 遗漏提醒
│   ├── make_report.py        # 可点击的 HTML 报告
│   ├── search_topic.py       # 话题检索(带上下文)
│   ├── pack_material.py      # 给 AI 备料(客观统计 + 抽样)
│   ├── autoconfig.py         # 冷启动分析(纯本地版)
│   ├── load_example.py       # 生成示例数据
│   └── demo-student.json     # 虚构示例数据
└── docs/                     # 截图
引擎随插件走(在 engine/ 里),数据在你自己的目录里 ——
两者彻底分开,所以你可以随时把数据目录指向别处,甚至放多份不同数据。
| 变量 | 作用 | 默认 |
|---|---|---|
QQREMINDER_ROOT | 数据根目录 | ~/QQreminder |
focus.json 就行python engine/load_example.py 就能自测MIT
示例数据里的人物、学校、群聊内容全部是虚构的,与任何真实个人或组织无关。 截图用的就是这份示例数据。
如果你要分享自己的报告截图,记得先看一眼里面有没有别人的真名 —— 群里说话的是活人,他们的名字不该因为你分享工具而出现在互联网上。
DeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
把回答做成一页可视化 HTML:模型只写简短的 Markdown 草稿,随包附带的 `am` 命令行生成页面,支持流程图、时序图、树、时间线、ER 图、表格和提示框。
在 dsh 里装上这个插件即可,无需登录、注册或填 API Key,就能使用包括 Muse Spark 1.3、MiMo V2.6 在内的前沿模型——完全免费,不限量。 All you do is install this plugin in dsh: no login, no sign-up, no API key — the frontier models are just there, Muse Spark 1.3 and MiMo V2.6 among them. Completely free, with no usage cap.

