

dsh-web
zhu1090093659/dsh-webDeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
在 AI agent 的聊天框旁边,放一张能画分子的画板 + 一个本地 RDKit 工作台。
画结构 → 点一下 → 分子式/分子量/logP/TPSA/类药性/结构警报当场算出来 → 把结构丢进对话,让 agent 接着往下讲。
纯 RDKit,零网络、零 API key、零外部服务。也可作为 stdio MCP 服务被 Claude Code / Codex 等直接调用。
中文 | English | 日本語 | 한국어 | Français | 繁體中文
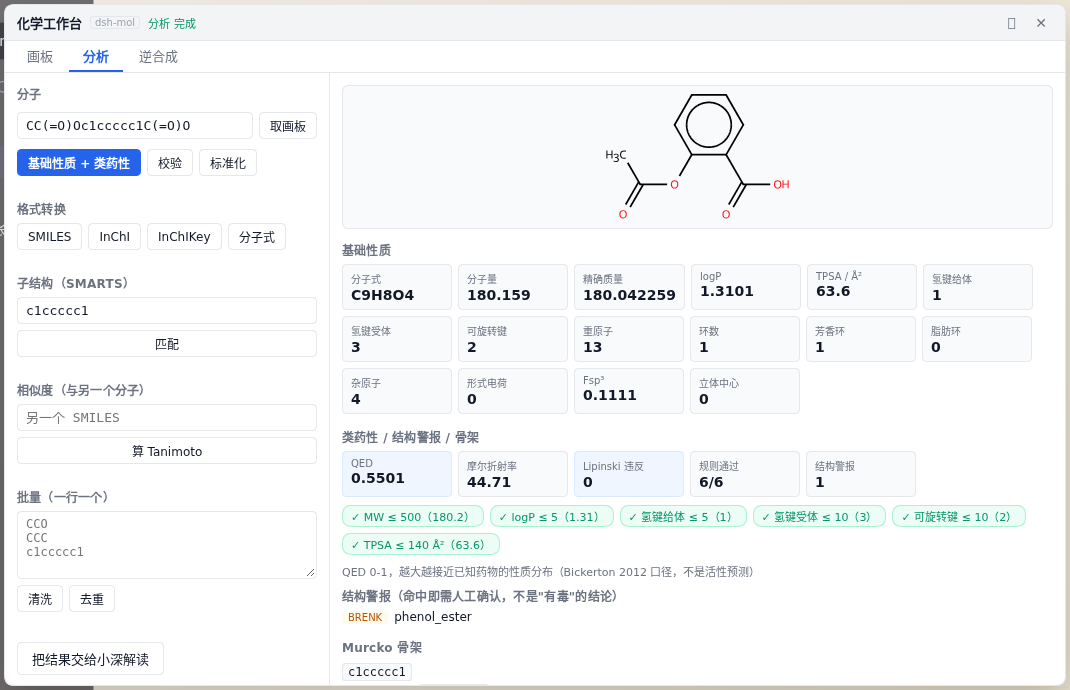
| 🎨 画分子 | 聊天框旁一个按钮 → Ketcher 画板浮层。聊天不会被顶掉,画完一键插进输入框 |
| ⚡ 即时分析 | 分子式、MW、精确质量、logP、TPSA、HBD/HBA、环数、Fsp³、立体中心 —— 本机 RDKit 现算,不走模型、不等 LLM |
| 💊 像不像药 | Lipinski / Veber 逐条判定、QED、PAINS / BRENK 结构警报、Murcko 骨架 |
| 🧹 脏数据急救 | 校验(人话报错 + 字符定位)、标准化(逐步记录改了什么)、去重、批量清洗 |
| 🧭 逆合成 | 页签已就位,后端可插拔(当前接 Retro*)。没装好模型就如实说没装好,绝不编一条路线出来 |
| 🔌 两种用法 | 图形工作台给人用;同一套核心又通过 MCP 给 agent 用 —— 一份实现,两个入口 |
顺带说个背景:npm 上确认有 618 个 DSH 插件,其中化学/材料/分子方向是 0 个。 这个仓库就是来填这个空格的。
# 1) 装核心 + MCP 适配层(已上 PyPI)
pip install 'dsh-mol[mcp]'
#    装不上时退回 git:pip install "dsh-mol[mcp] @ git+https://github.com/Yijian-quiet/dsh-mol.git"

# 2) 把插件装进你的 DSH profile(无需 npm 账号,pnpm 支持 git 子目录)
dsh plugin --profile web add 'github:Yijian-quiet/dsh-mol#path:dsh-bundle'
dsh plugin --profile web add 'github:Yijian-quiet/dsh-mol#path:dsh-ui'   # ← 图形工作台

# 3) 打开 DSH Web,点输入框左边的「工作台」
✅ 已发布到 PyPI:
pip install 'dsh-mol[mcp]'(2026-09-26 上线,装完dsh-mol-mcp --selftest可自检)。 ⏳ npm 尚未发布,所以插件本身仍用dsh plugin add github:…安装 —— 不影响任何功能。✅ 本插件已被 dsh 插件市场 收录(
dsh-mol#dsh-ui与dsh-mol#dsh-bundle两条,分类tools),也可以直接在市场里装。
工作台需要本地有一个能 import rdkit 的 python3;画板用的是 Ketcher 静态构建,在浏览器本地渲染,不经过任何后端。
dsh-mol-mcp --selftest # 先自检(不需要任何 MCP 客户端)
# 手动叠加 patch,stdio 传输,纯本地
- insert:
    - id: dsh-mol
      name: '@deepseek-ai/dsh-mcp-client'
      config:
        serverName: chem
        transport: stdio
        command: python3
        args: ['-m', 'dsh_mol_mcp.server']
        env:
          PYTHONPATH: /path/to/dsh-mol/src
          MOL_OUT: /path/to/out
工具名会以 mcp__chem__chem_check_smiles 之类出现在模型侧。
三个页签,一个分子:
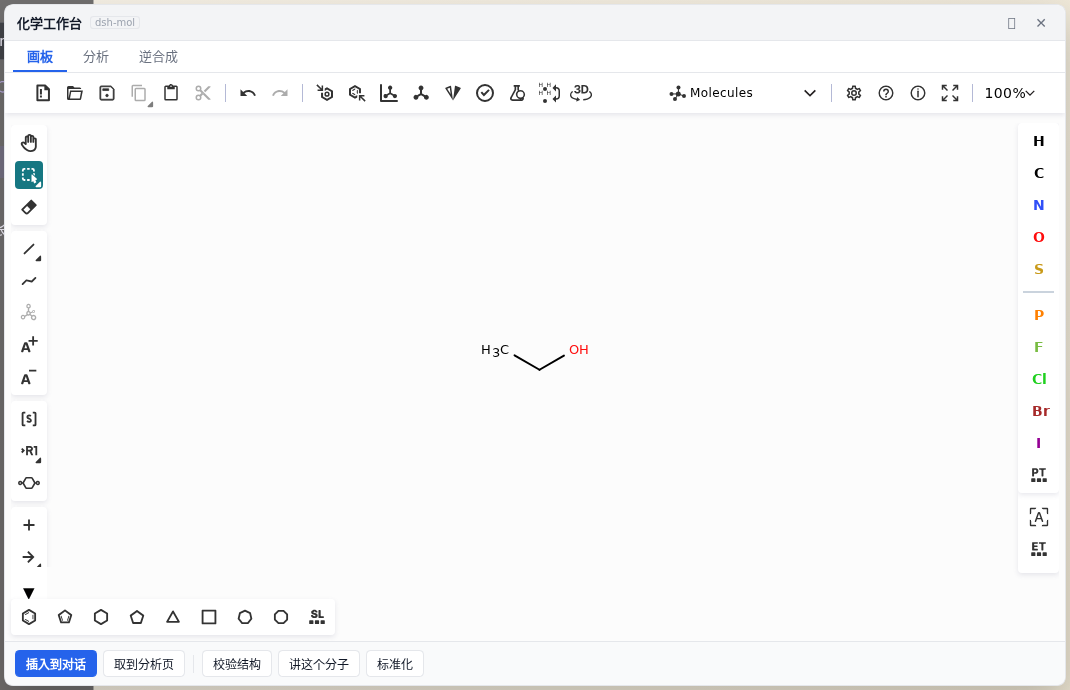 ① 画板 Ketcher 全功能画板(浮层可拖动、可最大化)。粘一段 SMILES 就能直接画上去(或点「读剪贴板」),画完点「插入到对话」把 SMILES 写进输入框 —— 文本只有结构本身,不夹带任何内部路径。 | ② 分析 左边输入/按钮,右边出数。基础性质 + 类药性 + 结构警报 + 骨架一次给全,全部是本地 RDKit 现算。 | 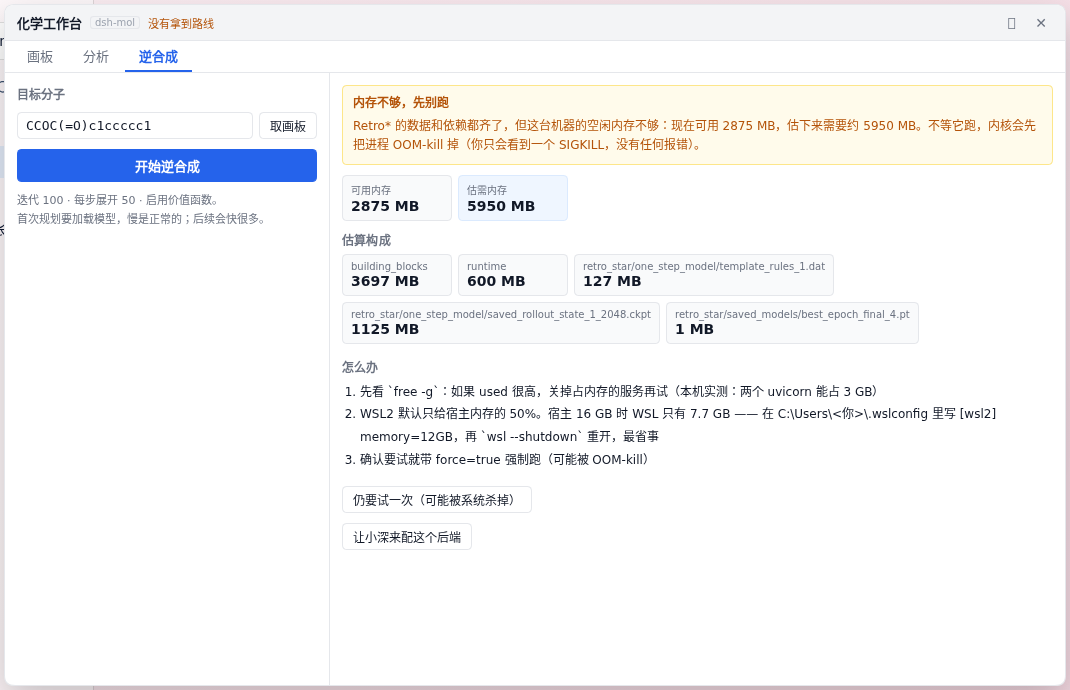 ③ 逆合成 目标分子 → 多步路线。未装模型数据时,它告诉你要下载什么、放哪里,而不是假装算过。 |
因为图应该跟着文字解释走。工作台里那张缩略图只是让你确认"算的是不是这个分子";
真正的结构图由 agent 在回复里内联画出来(read_image),旁边就是它对这分子的解释。
这个选择是被用户否掉两版之后定下来的: 先是"面板占掉主区域把聊天挤没了",再是"在画板里再画一张预览图没什么用"。 现在是聊天保持原样,工作台在旁边。
因为直接包一层会给 AI agent 三个坑,这三个坑在科研场景里都会真实咬人:
None失败原因写在 C++ 层的 stderr。天真包装下,模型只会拿到一个空洞的 None,完全不知道错在哪。
本工具把 RDKit 日志改道、捕获、翻译成人话,并在能定位时给出字符位置:
// chem_check_smiles("C1CC")
{ "level": "error",
  "diagnostics": [{ "code": "unclosed_ring",
                    "message": "环闭合标记没有配对:SMILES 里的成环数字(如 C1...C1)出现次数必须是偶数" }] }

// chem_check_smiles("CC(=O)O)")   ← 多余右括号,定位到第 7 个字符
{ "level": "error", "position": 7,
  "diagnostics": [{ "code": "extra_paren", "message": "多余的右括号:) 比 ( 多" }] }
MolFromSmiles("") 返回的不是 None,而是一个 0 原子的"空分子"天真写法会把空输入判成合法。而 " "(纯空白)又会返回 None——
同一个函数,两种空输入两种行为。本工具在领域层统一拦住。
[Fe+9] 能解析,但电荷荒谬。这类应该警告而不是拒绝:
| level | 含义 |
|---|---|
ok | 干净通过 |
warn | 能解析,但结构可疑(异常电荷、芳香性可疑…),附带原因 |
error | 解析失败,附人话原因 + 可定位的字符位置 |
并且:批量接口绝不静默丢数据。 每一行都有明确归属(ok / warn / failed), 失败逐条列出——科研数据里"悄悄少了两行"比报错危险得多。
默认中文;英文环境设一个环境变量即可:
export MOL_LANG=en # zh(默认)/ en
⚠️ 契约是
code,不是文案。code(unclosed_ring/valence…)与语言无关, 也不随语言改变 level / position / canonical——有专门的回归用例锁住这一点。
| 工具 | 作用 |
|---|---|
chem_check_smiles | 校验 + 规范化,三级结果 + 人话原因 + 字符定位 |
chem_properties | 分子式 / MW / 精确质量 / logP / TPSA / HBD / HBA / 环数 / 手性中心 |
chem_analyze | 一次给全:基础性质 + 类药性 + 结构警报 + Murcko 骨架 |
chem_druglikeness | Lipinski / Veber 逐条判定、QED、PAINS / BRENK 结构警报 |
chem_draw_molecule | 画结构图(PNG/SVG,可标原子编号、可高亮子结构),返回文件路径 |
chem_draw_grid | 多分子拼图(汇报/论文附图),坏条目跳过但逐条记录 |
chem_convert | smiles / inchi / inchikey / mol / sdf / formula 互转 |
chem_bioseq | 肽 / 核酸序列、HELM 或 IDT 记法 → 分子(给出规范 SMILES,可续接其它工具);kind 必须显式指定 |
chem_standardize | 去盐 / 去金属 / 中和 / 规范化,逐步记录改了什么 |
chem_dedupe | 按规范化结构去重,给出重复分组 |
chem_substructure_match | SMARTS 子结构匹配,返回原子索引 |
chem_similarity | 指纹相似度(morgan / rdkit / maccs) |
chem_batch_clean | 批量清洗一列 SMILES,输出计数摘要 + 失败清单(可写 CSV) |
工作台的「分析」页签跟这些工具共用同一个 chemcore —— 不存在"界面上算一套、agent 算另一套"的漂移。
chem_core还有一个python3 -m chemcore.cli的 JSON 入口(一行 JSON 进、一行 JSON 出), 工作台的即时数字就是走它。这是"给 AI 的工具"和"给人的界面"共用一份实现的接缝。
Ketcher 的大分子编辑器画出来的肽 / 核酸没有 SMILES,只有序列或 HELM。chem_bioseq
把它们解析成分子,并返回一个规范 SMILES —— 于是上面所有工具(properties / analyze /
draw / convert)都能接着用同一个分子算下去。
cc.parse_bioseq("GAVL", kind="peptide")            # 肽,1 字母码 → C16H30N4O5 / 358.4
cc.parse_bioseq("Gly-Ala-Val", kind="peptide3")    # 肽,3 字母码 → 三肽 C10H19N3O4 / 245.3
cc.parse_bioseq("AUGC", kind="rna")                # RNA → C38H48N15O26P3 / 1223.8
cc.parse_bioseq("ATGC", kind="dna")                # DNA → C39H50N15O22P3 / 1173.8
cc.parse_bioseq("PEPTIDE1{G.A.V.L}$$$$")           # HELM:前缀自带类型,auto 即可
kind因为 A/T/G/C 既是氨基酸字母也是碱基字母(Ala/Thr/Gly/Cys ↔ 腺嘌呤/胸腺嘧啶/鸟嘌呤/胞嘧啶)。
同一段 ATGC 按肽算是 C12H22N4O6S、按 RNA 算是 C39H50N15O26P3、按 DNA 算是
C39H50N15O22P3 —— 三个完全不同的分子,而 RDKit 的 MolFromSequence 默认只按肽解析、
不报任何错。
所以本工具的规矩是:
kind(auto 也要求),否则直接报错 ——
「无法判断 … 是肽还是核酸,已拒绝解析」。绝不替调用方选默认值:
选错是"化学上完全错误且没有任何迹象",比报错危险得多。auto 能确定推断的只有两类自带类型信息的记法:HELM(它的 PEPTIDE1{ / RNA1{ / DNA1{ 前缀是声明,不是猜)和 IDT(糖型前缀 r/d 同样是声明)。除此之外 auto 一律拒绝 —— 裸序列(ACGU / ATGC / GAVL)没有类型信息,不会拿到默认值。两个相关的 RDKit 坑(都实测过,本项目都绕开了):DNA 的 flavor 是 6 不是 3 (3 是"给 RNA 加 5' 磷酸帽",会多接一个磷酸);而 3 字母氨基酸码 RDKit 2023.09.6 根本不支持 —— 它会把
Gly-Ala-Val按大小写不敏感的单字母读成 9 肽(MW 890.1)且 不报错,所以peptide3由本层自己翻译成 1 字母码再算。序列里的空白也会被 RDKit 悄悄变成额外的氢,本层先规范化并把这次改动记进warnings。
Ketcher 的大分子编辑器导出核酸时给的是 IDT 记法(实测画 RNA 得到 rArCrGrTrU/3Phos/):
残基带糖型前缀(r=核糖、d=脱氧、m=2′-O-甲基、+=LNA),还有 /3Phos/、/5Phos/ 这类末端修饰。
chem_bioseq 直接吃它 —— kind 取值因此多了 idt(auto 也认:糖型前缀是声明,不是猜)。
但只在无损时才转换。 糖型统一、又没有修饰,才转成纯序列交给 RDKit;只要有一点它表达不了,就拒绝并说明原因:
cc.parse_bioseq("rArCrGrTrU", kind="idt")         # → RNA ACGTU / MW 1543.997(糖型统一、无修饰,无损)
cc.parse_bioseq("rArCrGrTrU/3Phos/", kind="idt")  # ✗ 拒绝:硬转会静默少掉一个 3′ 磷酸(≈79.97 Da)
拒绝时一律指名道姓,不含糊:
/3Phos/、/5Phos/、*(硫代磷酸)m(2′-O-甲基)、+(LNA)rArCdT(同一串里既有核糖又有脱氧 —— RDKit 一次只能表达一种)kind 冲突:rArCrG + kind="dna"(前缀声明的是 RNA)理由和上面一样:硬转不是"近似",是化学上完全错误且看不出任何异常 —— 分子量少了 79.97 Da,界面上却毫无异样。
import chemcore as cc

cc.check("C1CC").diagnostics[0].message   # '环闭合标记没有配对:…'
cc.properties("CC(=O)Oc1ccccc1C(=O)O")    # {'formula': 'C9H8O4', 'mw': 180.159, …}
cc.analyze("CC(=O)Oc1ccccc1C(=O)O")       # + QED / Lipinski / PAINS 警报 / Murcko 骨架
cc.draw("CCO", atom_indices=True)         # {'path': '…/CCO.png', …}
cc.standardize("CC(=O)[O-].[Na+]")        # {'output': 'CC(=O)O', 'changes': [...]}
cc.batch_clean(["CCO", "C1CC"])           # {'ok': 1, 'failed': 1, 'failed_items': [...]}
cc.parse_bioseq("GAVL", kind="peptide")   # 肽/核酸/HELM → 分子 + 规范 SMILES(kind 必填)
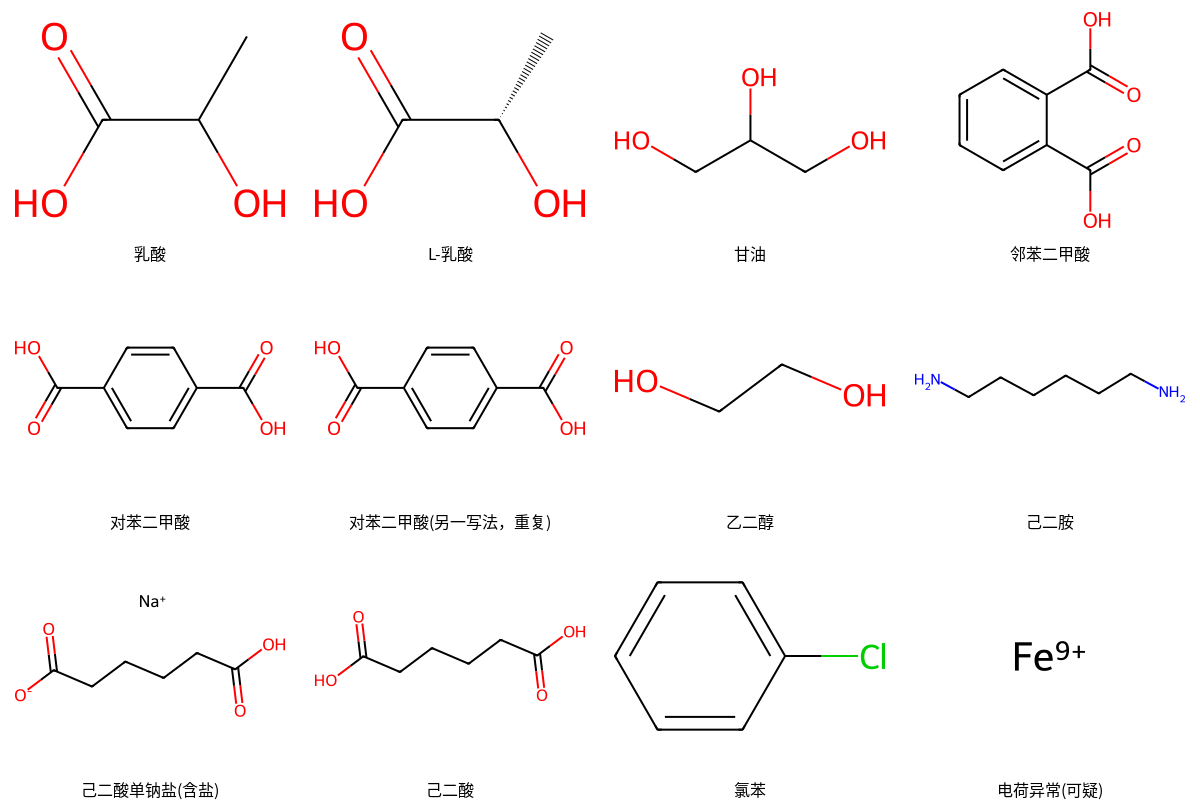
examples/monomer_cleanup.py 拿一张刻意做脏的单体表
(同一分子两种写法、一个钠盐、一个环未闭合错字、一个价键超限、一个离谱电荷)跑完整条链:
python3 examples/monomer_cleanup.py
它报出 通过 11 · 警告 1 · 失败 2、把重复项合并、逐步展示去盐与中和的每一步,
并把能画的 12 个结构画出来、把跳过的 2 个连原因一起列出来。
逆合成页签的后端是可插拔的:插件用 child_process 起一个"喂 JSON 进 stdin、
读 JSON 出 stdout"的进程,默认指向仓库里的 Retro* 桥接脚本。
retroCommand 指过去即可安装 Retro*(源码 + 模型数据,GB 级)见 docs/RETROSYNTHESIS.md。
PYTHONPATH=src python3 tests/run_tests.py    # 71 个核心用例(零依赖,不需要 pytest)
PYTHONPATH=src python3 tests/mcp_smoke.py    # MCP 协议级冒烟(真起服务、真调工具)
bash tests/run_all.sh                        # 上面两件 + 自测,一把梭
界面用 Playwright 无头验收(39 条断言,覆盖"打开工作台后聊天还能不能用""数字是不是真算的" "后端没装好时会不会编路线"):
dsh web --port 3081 --no-open > /tmp/chemver.log 2>&1 &
CHEM_BASE=http://127.0.0.1:3081 \
CHEM_TOKEN=$(grep -o 'token=[^ ]*' /tmp/chemver.log | cut -d= -f2) \
node dsh-ui/tests/verify-ui.cjs
别拿你正在用的那个端口做实验 —— 另起一个实例,跑完就关。
mw / exact_mw 分别说明含义。logP、TPSA、QED 都是计算/估算值,不替代实验测量。peptide3 只认 20 种标准氨基酸的三字母码;修饰残基、非天然
单体、糖链等在 RDKit 这一层没有可靠支持。另外实测 RDKit 2023.09.6 的 HELM 解析
不支持 DNA1 与 CHEM1(直接返回 None),碰到时我们明确报错,而不是给个空结果。A/T/G/C 在肽与核酸里都合法,裸序列有歧义时我们拒绝解析,
不提供默认值(详见上面「大分子」一节)。* 虚原子:聚合物 RU-SMILES(如 *OCCOC(=O)c1ccc(C(=O)O*)cc1)转不了 InChI / InChIKey。
我们不会静默返回空串(RDKit 会),而是明确报错并建议用 canonical SMILES 做唯一标识 ——
因为这个领域最常见的输入正好就是带 * 的。src/chemcore/ 纯 RDKit 核心(唯一的事实来源)+ JSON CLI 入口
src/dsh_mol_mcp/ stdio MCP 适配层(13 个工具)
dsh-ui/ 化学工作台(DSH 客户端插件:宿主半边 + 浏览器半边)
dsh-ui/retro/ 逆合成后端桥接(可插拔,默认 Retro*)
dsh-bundle/ DSH 组合包(只贡献配置,指向上面的 MCP 服务)
dsh/ 手动叠加用的 patch(写死本机路径)
tests/ 零依赖测试 + MCP 协议冒烟 + Playwright 界面验收
docs/ 演示图与专题文档
MCP Python SDK 必须 1.x:
pip install 'mcp>=1.0,<2'
SDK 2.x 把 FastMCP 改名成了 MCPServer,API 有破坏性变更。
我们的 [mcp] extra 已钉住 <2;如果你手工装了 2.x,dsh-mol-mcp 会明确告诉你怎么办
(而不是甩一条 traceback)—— 这个坑是 CI 在干净环境里实测出来的,不是推测。
MIT
DeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
把回答做成一页可视化 HTML:模型只写简短的 Markdown 草稿,随包附带的 `am` 命令行生成页面,支持流程图、时序图、树、时间线、ER 图、表格和提示框。
在 dsh 里装上这个插件即可,无需登录、注册或填 API Key,就能使用包括 Muse Spark 1.3、MiMo V2.6 在内的前沿模型——完全免费,不限量。 All you do is install this plugin in dsh: no login, no sign-up, no API key — the frontier models are just there, Muse Spark 1.3 and MiMo V2.6 among them. Completely free, with no usage cap.

