
dsh-web
zhu1090093659/dsh-webDeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)

DSH Web 右侧栏的思维链面板:把每个会话的实时思考折成 turn → step 分组,每一步带该步的思考原文与工具调用。默认只展开最新一轮,更早的轮次收成一行;步骤按本地规则合并成阶段块,正在等工具的那一步单独标出,工具失败显示原因,思考原文按步按需取回,全轮目录在本地搜索轮次标题、用户原话与轮号,整轮可用一次模型调用生成中文标题。
在 DSH Web 的右侧栏开一个「思维链」标签页, 把模型的实时思考按
turn → step →(思考原文 + 工具调用)聚合成能读的结构: 每一步在干嘛、调了什么工具、它在读哪个文件、哪一段正在等外部接口。
DSH 的主对话界面不显示思维链。 而模型的思考恰恰是最值得看的东西: 它决定得对不对、有没有绕路、卡在哪一步。
但直接把思考流倒出来是没法读的。这是真实会话里量出来的一个 turn:
| 实测 | |
|---|---|
| 一个 turn 的步数 | 53 |
| 一个 turn 的时长 | 1550 秒(约 26 分钟) |
| 一个 turn 的思考量 | 7.1 万字 |
| 一个 turn 的工具调用 | 68 次 |
所以这个面板做了五件事,每一件都对应上面某个数字:
sseThrottleMs)。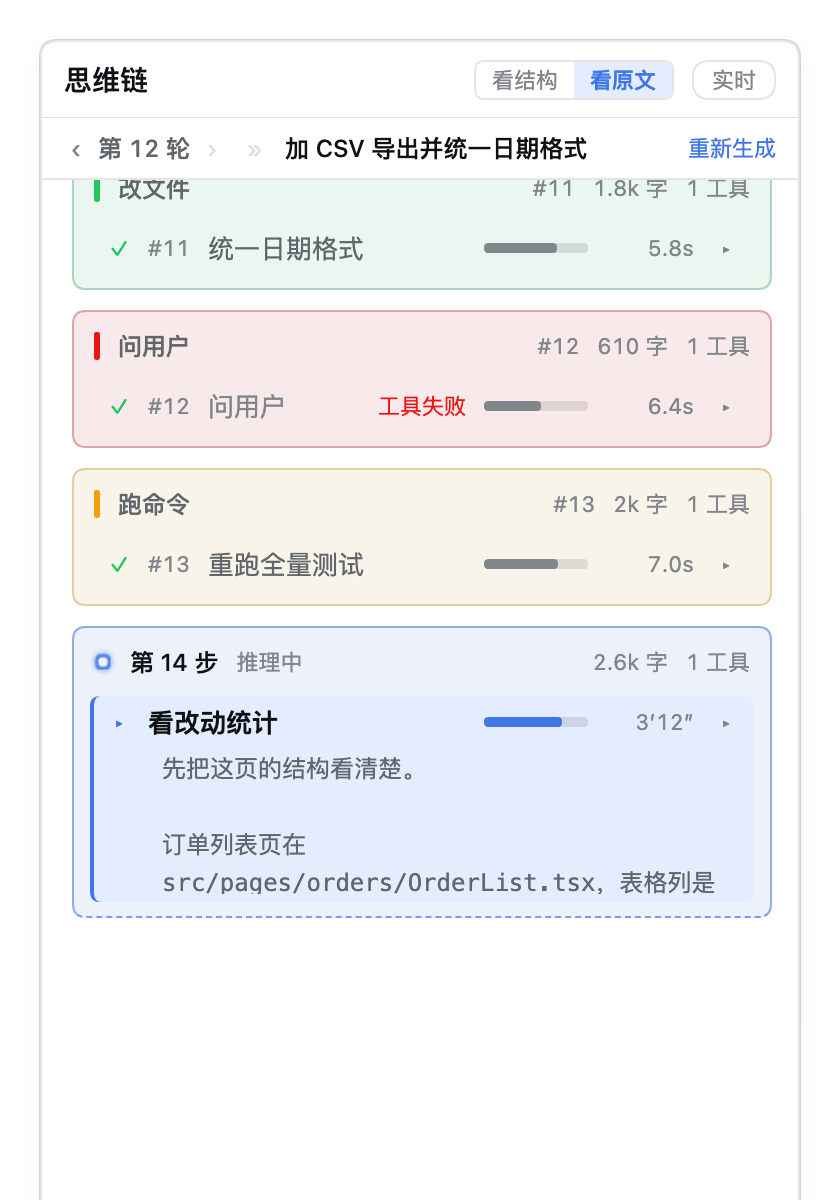 | 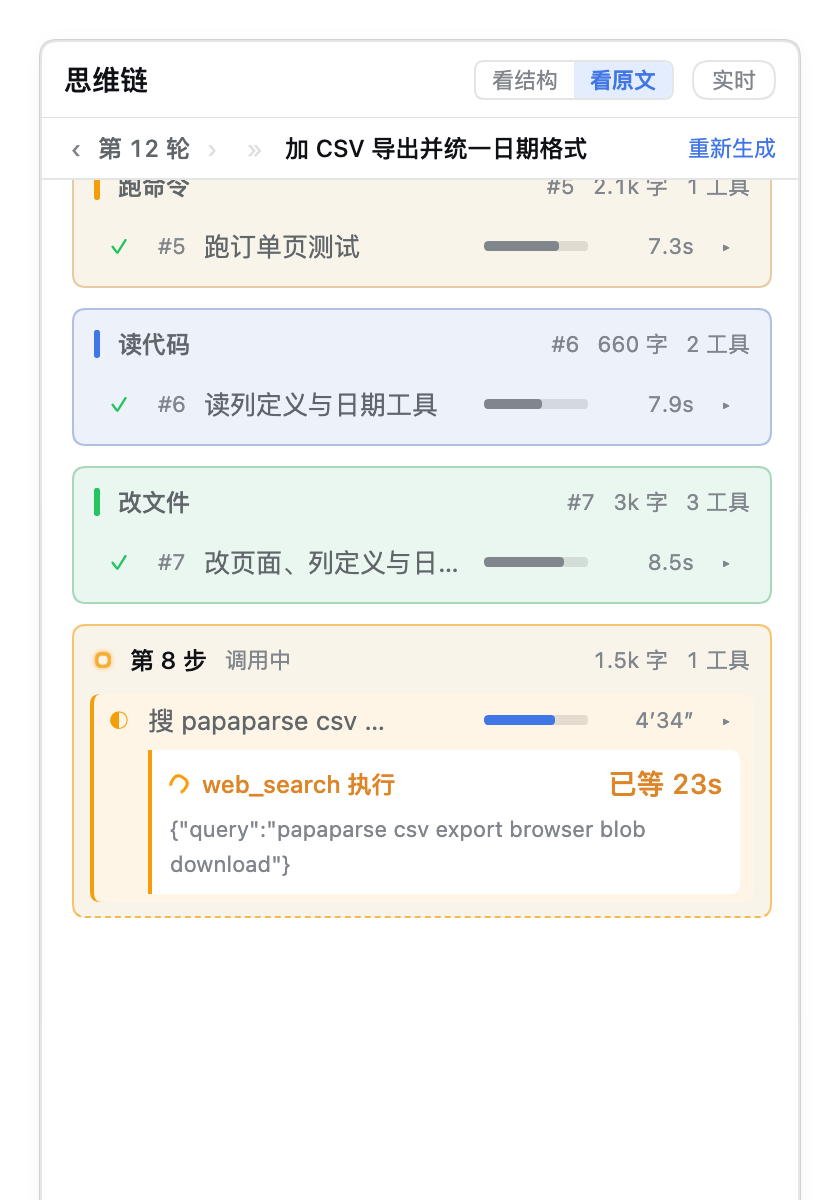 |
| ① 正在思考 当前步整块高亮、呼吸环 + 秒表实时涨; 每行右侧容量条 = 那一步的思考 Token 数 | ② 正在等工具 唯一的高亮块: web_search 执行 · 已等 23s把"在等外部接口"和"卡死"分开 |
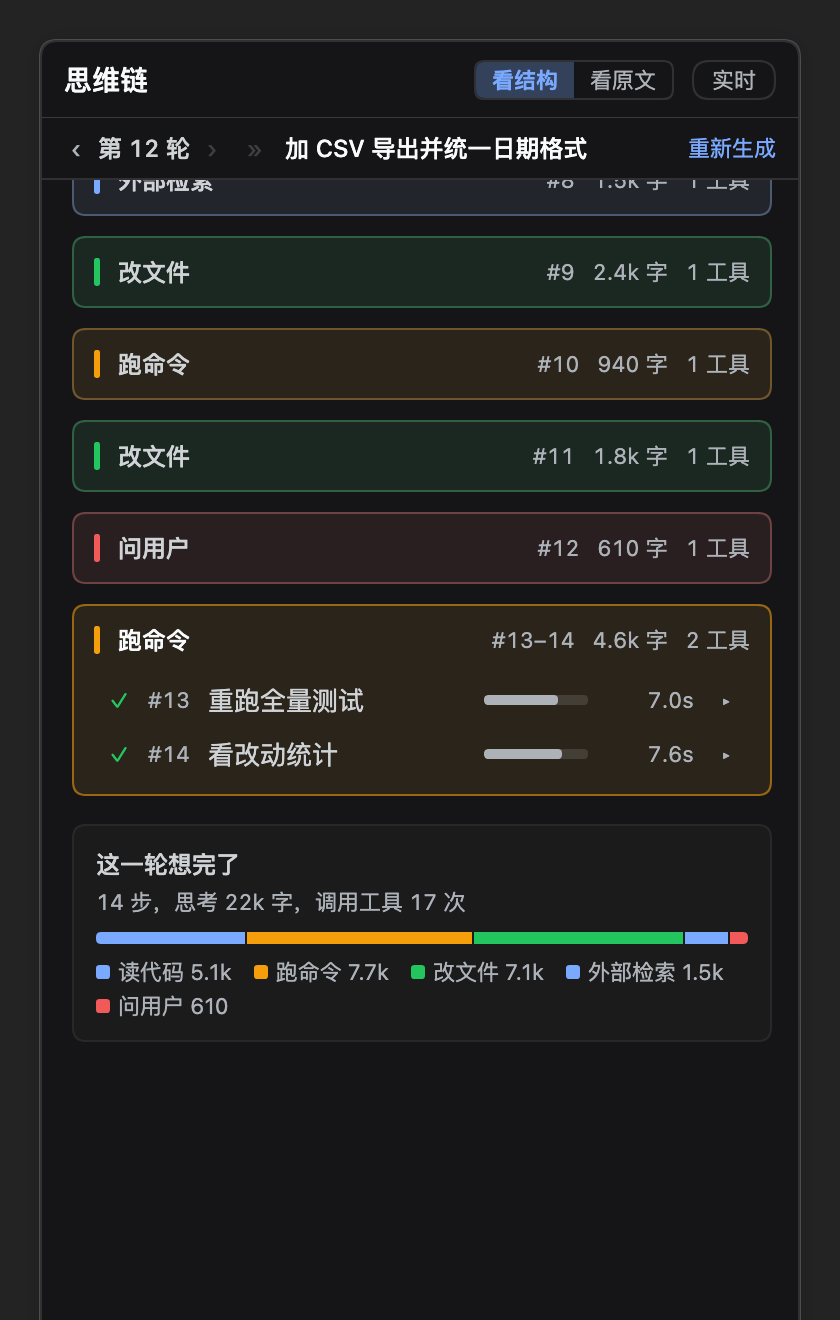
本轮结束后补一块**「这一轮想完了」**:多少步、思考多少 Token、调了多少次工具,以及 思考花在哪了(读代码 / 跑命令 / 改文件 / 外部检索 / 问用户的比例)。 分布用同一色相只变深浅,不给每个阶段编一个颜色。
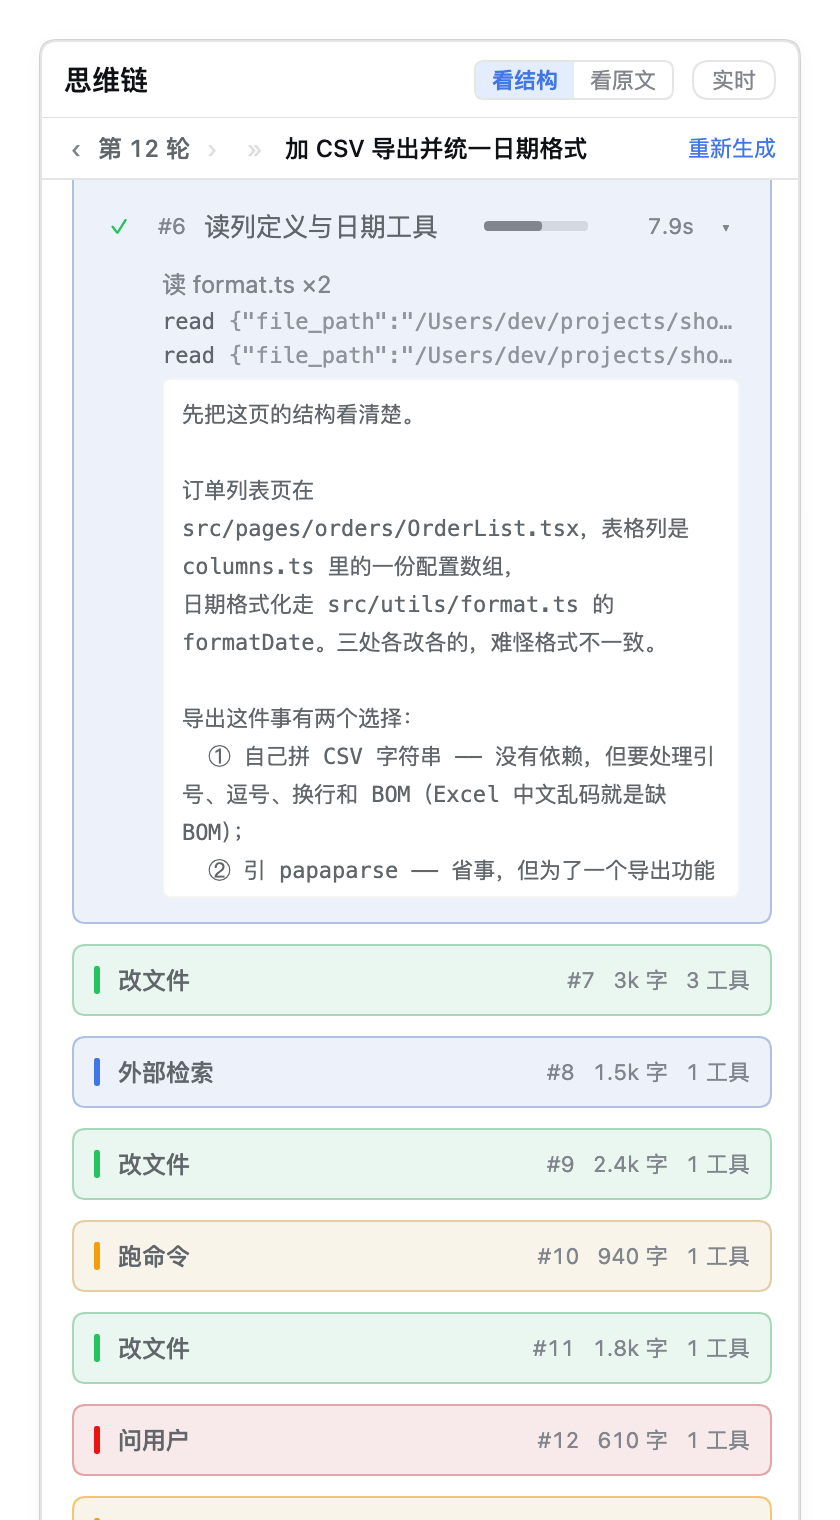 | 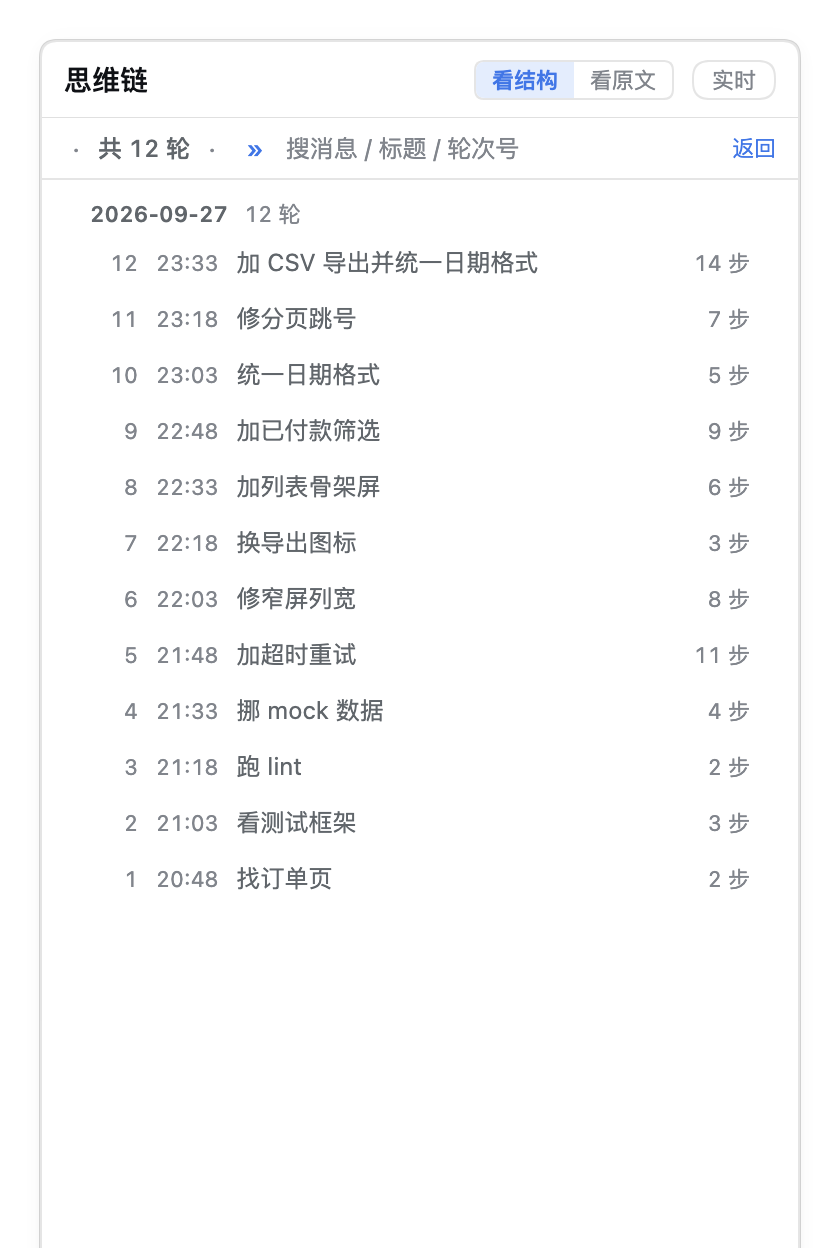 |
| ③ 展开某一步 模型标题 → 次级标题(按工具参数算的派生标题) → 工具详情 → 按需取回的思考原文 | ④ 全轮目录 第二行标题双击就地变搜索框; 12 轮、100 轮都在这儿翻,搜索全在本地算 |
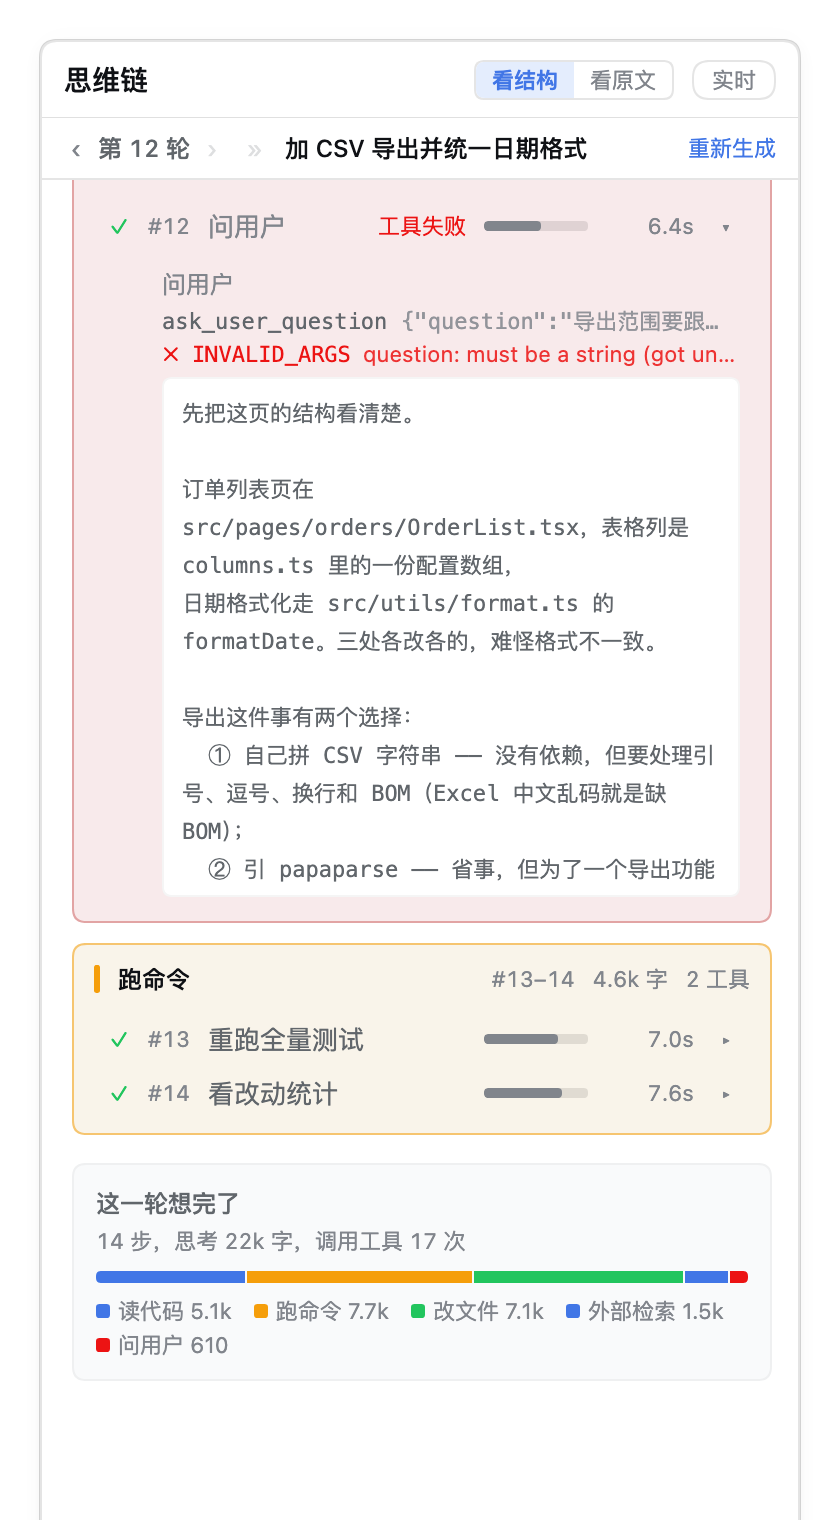
工具失败照宿主的判定显示(isError + error.code):行里一枚红标,
为什么失败在展开区紧跟它自己那条工具行(上图 ✗ INVALID_ARGS …)。
红只给错误文本,工具名不动 —— 失败的是这次调用,不是这个工具。
上面这些图不是另画的示意图:由
npm run shots用构建产物里真正的组件渲染、 配宿主主题包里整段抓出来的真 token、headless Chrome 拍下来,宽度就是右侧栏真实的 380px。 数据来自scripts/preview/demo-data.mjs,是合成的一段会话。
# 从 npm(推荐)
dsh plugin --profile web add @yfwu2020/dsh-think-flow

# 或从 GitHub Release 的 tgz(同一个产物,不走 npm)
dsh plugin --profile web add /path/to/yfwu2020-dsh-think-flow-0.3.3.tgz

# 或从本地目录(开发用:改完不用重装,只重建)
dsh plugin --profile web add link:/path/to/dsh-think-flow
装完在 DSH 里落成三处:
| 位置 | 内容 |
|---|---|
~/.dsh/profiles/web/package.json | "@yfwu2020/dsh-think-flow": "<版本或 link:路径>" |
~/.dsh/profiles/web/node_modules/@yfwu2020/dsh-think-flow | 软链 → 插件目录 |
profile 的 dsh.profile.bundles | 包名(按包名引用,与路径无关) |
打开方式有两个:会话头部那个折线图标,或者右侧栏标签条上的「思维链」。
⚠️ 装完要重建进程:host 半是新的 bundle,需要重启
dsh web,之后硬刷新浏览器 (Cmd/Ctrl+Shift+R)。此后只改 client 半的改动会被client-hmr就地替换,不用刷新。
要求:DSH 运行时 >=0.1.7-rc(见 package.json 的 peerDependencies)。
0.1.7-rc 起 createSystemMessage 去掉了插件署名参数;更旧的运行时上行为不一致。
⚠️ npm 上
@deepseek-ai/*这些包的latest还停在更旧的0.0.1-rc.x,缺WebServer等 API —— 从源码构建时按package.json里钉的版本装,别用latest。
改 profile 的 cordis.patch.yml 里 id: think-flow 那一行的 config:(覆盖,不要再 insert):
- id: think-flow
  config:
    maxTurnsPerSession: 20
| 键 | 默认 | 范围 | 含义 |
|---|---|---|---|
maxTurnsPerSession | 20 | 0–500 | 每个会话常驻多少轮的正文(0 = 不限)。⚠️ 这是正文窗口,不是"能看到多少轮" |
maxIndexTurns | 2000 | 0–20000 | 目录(全轮骨架)最多记多少轮。一轮骨架几百字节,所以给得宽 |
coldTtlMs | 7200000 | 0–86400000 | 按需折进来的冷轮正文保留多久(空闲计时:读一次续一次期。0 = 不按时间收) |
maxColdChars | 4000000 | 0–2e8 | 冷轮正文的硬上限。和 coldTtlMs 是两条独立策略,谁先到算谁 |
maxReasoningCharsPerStep | 120000 | 1000–400000 | 单个 step 的思考原文上限,超了从尾部保留并打上"这段不全" |
maxSessions | 32 | 1–256 | 内存里同时跟踪多少个会话(LRU) |
resyncSilenceMs | 15000 | 20–600000 | 内存轨迹多久没收到实时动静就算"可疑"(也是重折退避的基数,见下) |
resyncMaxGapMs | 300000 | 0–3600000 | 重折退避的上限(0 = 关掉过期自愈)。不是"最多重折几次"—— 见下面的说明 |
sseThrottleMs | 120 | 0–2000 | 合并推送的最小间隔。别调到 0:流式每秒几百个事件 |
heartbeatMs | 15000 | 2000–120000 | SSE 心跳,防代理掐连接 |
snapshotTailChars | 4000 | 200–20000 | 连接快照里给"当前步"带多少字符原文(其余步骤走 /step 按需取) |
titleStepChars | 420 | 80–4000 | 生成中文标题时,每一步最多喂多少字思考原文 |
titleTotalChars | 24000 | 2000–200000 | 一次标题请求的字符上限(整轮一起总结,一次调用) |
titleReasoningEffort | 'low' | — | 生成标题的推理档位(压缩任务,低档就够) |
titleCachePath | '' | — | 标题缓存路径。空 = ~/.dsh/think-flow/titles.json |
autoTickMs | 5000 | 20–60000 | 自动标题(面板上的「实时」)的节拍器间隔 |
maxHydrateEvents | 20000 | 0–200000 | 历史回看时最多折入多少条落盘事件(从最新往回取) |
maxTitledTurns | 640 | 0–10000 | 标题缓存最多保留多少轮 |
translateTarget | 'zh-CN' | — | 思考原文机翻的目标语言 |
translateProvider | '' | — | 机翻提供方(bing / google)。空 = 跟随 translator 服务自身的配置(默认 bing)。付费路由要写会话日志,本插件对会话只读,别用 |
translateMaxChars | 3600 | 200–4000 | 单个翻译请求的字符上限(再和 translator 的 maxTextChars 取小) |
translateTimeoutMs | 20000 | 1000–120000 | 单次翻译请求超时 |
translateCachePath | '' | — | 译文缓存路径。空 = ~/.dsh/think-flow/translations.json |
maxTranslationEntries | 4000 | 0–100000 | 译文缓存最多保留多少条(一段一条,LRU) |
三条策略要一起看(它们管的是同一块内存):
turns(正文)        maxTurnsPerSession = 20   ← 常驻
  └ 更早的轮次按需折进来 = 冷轮正文
       ├ coldTtlMs    = 7,200,000   空闲 2 小时收回
       └ maxColdChars = 4,000,000   字符超了从最旧的丢
index(全轮骨架)    maxIndexTurns = 2000      ← 目录读它;正文丢了它还在
时间策略管"不用了就还回来",但它没有内存上界(两小时里连开几百个老轮次会一直涨), 字符上限补的正是那个洞 —— 所以两条都建议留着。
清理全是自动的,没有手动入口(要手动只能删文件或重启进程)。除上面那些,
还有两处硬编码上限:trace.attempts 是 128 条 FIFO;订阅者的增量队列由节流窗口清空。
另外卸载插件不会删 ~/.dsh/think-flow/(标题缓存与译文缓存留着,重装即复用)。
模型的思考原文是英文。面板头部那枚「中文」按钮把它按段落翻成中文。 按钮上永远只有两个字,状态靠亮 / 呼吸区分(点一下依次是 关 → 开 → 实时 → 关, 选择记在浏览器里;鼠标悬停会说明"现在是什么状态、点一下会发生什么"):
| 状态 | 按钮长相 | 行为 |
|---|---|---|
| 实时(默认) | 中文:实心蓝 + 呼吸 | 边流边翻:折叠态那条实时流也翻,翻好一段显示一段 |
| 开 | 中文:常亮淡蓝 | 流式输出时一个字都不翻;只有你展开某一步时才翻这一步 |
| 关 | 中文:不亮 | 原文,一个请求都不发 |
呼吸只用来提示"实时"。系统开了「减少动态效果」时呼吸会停,但实时态仍是实心蓝, 和「开」的淡蓝分得开 —— 状态不依赖动画存在。
@deepseek-ai/dsh-experimental-cot-translation-bundle 是同一个底座。🔒 翻译意味着把段落发给第三方(Bing / Google 的匿名翻译端点)。不想外发就切到 「关」—— 之后面板一个翻译请求都不发,宿主也不会主动翻任何东西。
⚠️ 需要宿主装
@deepseek-ai/dsh-experimental-translator(装@deepseek-ai/dsh-experimental-cot-translation-bundle就会带上它)。 没装时开关禁用并给出原因,插件其余功能完全不受影响。
译文缓存两层的上限都是硬的:浏览器内存 3000 段(LRU,页面刷新即清空)、
宿主内存/磁盘 4000 段(maxTranslationEntries,落盘到
~/.dsh/think-flow/translations.json,约 1MB 量级)。越界按最近使用淘汰;
被淘汰的段落下次显示时重新翻(宿主磁盘里还有的话直接命中,不走网络)。
卸载插件不会删缓存文件。
| 想干的事 | 怎么做 |
|---|---|
| 看结构 / 看原文 | 头部 看结构 | 看原文 切换。实时默认「看原文」,切过去就展开本轮 |
| 思考变中文 | 头部「中文」按钮:不亮 = 关;常亮 = 开(只在展开某一步时翻);常亮 + 呼吸 = 实时(边写边翻)。悬停看当前状态。见上一节 |
| 展开某一步 | 点行尾的 ▸。展开区依次是:次级标题(派生标题)、工具详情、思考原文(以及回答正文) |
| 看某一步在等什么 | 悬停那一步 —— 悬停里给全工具体、机读码、失败原因 |
| 回到更早的轮次 | 双击第二行标题进目录;或点轮号两侧的 ‹ › 走相邻轮 |
| 在主会话里跳到某一步 | 点步骤行前面那枚 #N —— 主会话在「轨迹」页时,跳过去并选中这一步(选中它的助手行:行变选中态、轮次标签高亮、右侧检查器打开这一条)。轨迹页行的身份里就带着 (轮, 步)(宿主给的 assistant\0<轮>\0<步>),所以"哪一行是哪一步"是读出来的,不用数、也不会错 |
| 在主会话里跳到这一轮 | 点第二行那枚轮次号(‹ 第 N 轮 › 中间那个)—— 主会话在「对话」就滚到这一轮的用户消息(离顶 24px,和宿主刻度同一套落位);在「轨迹」就滚到那一轮的用户记录并选中它(行变选中态、轮次标签高亮、右侧检查器打开这一条)。不给自己加底色/动画:对话页靠滚动位置说话,轨迹页靠宿主的选中态说话 |
| 找某一轮 | 目录里那个搜索框:搜用户原话 + 轮次标题 + 轮号,全在本地算,零请求 |
| 给整轮起个中文标题 | 点第二行右侧的「生成标题」(整轮一次模型调用,结果落盘缓存;再点走缓存) |
| 每轮自动起标题 | 头部「实时」开关(默认关,开着才按 autoTickMs 节拍自动生成) |
几个不显眼但有用的:
✓ 完成 · ▸ 进行中 · ◐ 等工具 · ■ 被中断。读 client.js、跑构建、改 index.js ×3)—— 所以任何时刻都看得出"这一步机械地做了什么"。
相邻的同类调用会合并成 ×N,杀掉重复又保住"调了几次"。跑构建 · 跑构建确认没回归)。
说明在 tool/call 那一刻采集 —— 参数会被截断,那是唯一能保住它的时机。会话读不到和"还没开始"是两件事,面板分开说(状态随快照下发):
| 状态 | 面板上 | 什么时候 |
|---|---|---|
live | 正常面板 | 收到了实时事件 |
hydrated | 正常面板 | 从落盘日志折出来的历史 |
empty | "这个会话还没有开始推理" | 刚开的会话,一个 step 都没有 |
unreadable | "读不到这个会话的思考记录" + 可能原因 | 会话被删 / 被别的进程占用 |
有实时事件进来时 unreadable 会回到 live,不会一直挂着。
事件是实时的、不回放,所以插件加载之前、以及更早的会话,内存里什么都没有。
现在打开面板时先补历史:/trace、/stream、/titles 三条路都会先 hydrate() ——
但只在该会话内存里还没有任何 turn 时做,绝不覆盖实时状态;读盘失败(会话不存在 /
被别的进程锁住)静默降级,实时数据照常返回。
一个关键差别:落盘的是组装结果,不是流帧。实时路径收到的是 reasoning-delta 增量,
历史路径读的是 assistant/message 里组装好的整块 —— 后者覆盖前者。覆盖是刻意的:
同一步重试会有多条 assistant/message,以最终那条为准更正确,顺带把流式缺口也补上了。
hydrate() 只在内存里空的时候做,可本进程不一定是这个会话的驱动者:换个客户端
接着看(dsh web → 桌面版)、或者上一轮是在另一个进程里被打断的 —— 那之后这个进程
再也收不到任何实时事件,打开面板那一刻折出来的"还在跑"就永远没人更正
(实测:那一轮 19:54 就中断了,21:53 面板还挂着"已等 59'46"",而且刷新页面也好不了)。
所以补一条:看着还在跑 + 这个进程好久没动静就把日志重折一遍,对不上就推一份新快照。
代价用退避兜住(resyncSilenceMs 为基数,15s → 30s → 60s…,封顶 resyncMaxGapMs),
真的在等一个长工具时,几次之后就是 5 分钟才读一遍日志。
⚠️ 这里刻意不用"一段沉默期最多折几次就停手":本进程不是驱动者时沉默期永远不会结束,
硬上限等于过一阵子永久停止自愈(改之前先写成了硬上限,真机立刻踩到)。
并发也收口了:hydrate() 是单飞的(同一会话同一时刻只有一趟)。两个面板同时连上来时,
之前会各自清空重建、后一趟把前一趟的"实时事件排队表"覆盖掉 —— 中间到的轮结束/工具结果
就再也没人补放,内存里那份永远停在"还在跑"。
宿主半注册在 /think-flow/api/* 下(curl -s localhost:3080/think-flow/api/ping 可自检):
| 路由 | 用途 |
|---|---|
GET /stream?session=<id> | SSE:先发一份快照,之后只发增量 |
GET /trace?session=<id> | 一次性快照(JSON) |
GET /step?session&turn&step | 按需取某一步的完整思考原文 |
GET /turn?session&turn | 从冷热缓存或日志按需取某一轮正文 |
POST /translate | 按段翻译思考原文(JSON 请求体,需启用 translator) |
POST /titles?session&turn[&force=1] | 生成某一轮的中文标题(只补缺的;force=1 整轮重算)。用 POST 是因为它会产生模型调用,不该被当成可缓存的 GET |
POST /auto?session&on=1|0 | 开关自动标题(默认关)。状态记在宿主侧,随快照回给面板 |
GET /sessions | 当前在跟踪哪些会话(轮数/步数/订阅者数) |
GET /ping | 诊断:build 号、帧/事件计数、缺口数、淘汰计数 |
快照刻意只带"当前步"的原文:一个 turn 实测 7 万字,53 步全带原文每次连接要传几 MB。
其余步骤只给 Token 数与状态,展开时走 /step,之后走缓存。
骨架(index[])里每一轮还带一个 seq:这一轮 turn/start 的事件序号。它只有一个用途 ——
面板里点轮次号时,客户端拿它调宿主的 session.loadThrough(seq),把主会话的历史一次翻到
这一轮(和宿主自己的「轮次导航」刻度是同一个调用)。所以"跳到某一轮"在大轮号上也点得动,
不必一页一页翻。
┌─ 宿主半  src/index.ts → src/host/* + trace/titles/translate ─────────┐
│                                                                       │
│  ctx.on('agent/assistant-stream')  ─┐                                 │
│  ctx.on('session/event')           ─┴→ 折成 turn → step →(思考+工具) │
│                                        每个会话一份,LRU 上限 32       │
│                                              │                        │
│                        ┌─────────────────────┼─────────────────────┐  │
│                        ▼                     ▼                     ▼  │
│                 /stream(SSE)         /trace(快照)       /step(按需)│
│                 120ms 合并推送          连接时发一次        展开时才取   │
└───────────────────────────────────────────────────────────────────────┘
                                 │
┌─ 客户端半  src/client/* → lib/client.js(ModuleLoader)──────────────┐
│  右侧栏标签页(真组件);样式**全部**来自宿主 --dsw-* token,深浅自动跟随 │
└───────────────────────────────────────────────────────────────────────┘
几个刻意的取舍:
stepStatus() 是纯函数,面板照抄宿主下发的状态,自己不推导 ——
早先两边各推一次,结果是"每一步跑完仍显示正在生成"。--dsw-*),一个硬编码色值都没有 —— 所以深浅色自动跟随,
也不会在宿主换肤后和界面其余部分不是一套语言。同族(read/grep/glob 都算"读代码",edit/write 算"改文件"…)且相邻、
间隔 < 90 秒的步骤合并成一个块。90 秒这个阈值是量出来的:夹在两次 grep 之间的
一个 npm test 用 20 秒阈值会把列表切成 9 个碎块,90 秒就不切。
命令行再按命令内容细分:只读命令(sed/grep/cat/ls)算「读代码」,
有副作用的(跑测试/构建/提交)算「跑命令」—— 实测一个会话 89 条命令里 70% 是前者,
28% 是后者,混在一起叫什么都不对。
面板上所有"多少"都是 Token(轮头的「思考 1.4k tok」、每行的容量条宽度、
收尾小结的条与图例比例),换算只有一处:src/trace.ts 的 tokenWeight()。
密度取 DeepSeek 官方给的经验值 —— 1 个英文字符 ≈ 0.3 Token、1 个中文字符 ≈ 0.6 Token。
(宿主自己的 dsh-token-meter 用的是"4 字符 = 1 Token"这套面向英文的固定密度,
对中文会低估一半以上;这个面板读的思考是英文 CoT、正文常常是中文,所以按字符宽度分档。)
为什么不用 provider 报的 usage.outputTokens:那是整个 step 的产出(思考 + 正文 + 工具参数),
拿它当"这一步想了多少"会把工具参数一起算进去;而且它只在一个尝试结束时才到,
面板上那根会长的容量条就再也长不起来了。所以口径统一走密度估算 ——
实时与历史是同一把尺子,宿主算、客户端照抄(两端各取一次整必然漂)。
⚠️ 它是估算:真值只有 provider 的用量有。容量条是 log10 映射(10~1600 tok → 条宽的 8%~100%),
所以 ±20% 的误差在图上几乎看不出来;要精确到 Token 的用量,看主会话自己的账单。
唯一还是"字符"的地方是内存预算(maxColdChars、maxReasoningCharsPerStep、
snapshotTailChars、titleStepChars 那几个配置)—— 那些管的是"留多少原文",
不是面板上报的统计。
试过用规则从工具参数起标题(现在仍是派生标题那条路,用来兜底),但它只能回答
"这一步机械地做了什么",回答不了"这一步在解决什么问题"。实测拿它当主标题,
一轮 40 步里有 26 步长得一模一样(都是 跑测试)。所以主标题交给模型
(一次调用、整轮一起总结、按内容指纹缓存),规则退回去做次级标题。
判据全部来自宿主的会话事件,面板一个都不猜:
| 事实 | 来源 |
|---|---|
| 这次调用失没失败 | message.isError === true(严格判等,脏数据里的字符串 'true' 不算) |
| 机读错误码 / 类名 | error 的 { name, code }(实测 104 条失败里 7 条没有 → 只印那句话) |
| 给人读的那句话 | message.content[].text,去掉 Error: 前缀;读不出就只留红标,不编内容 |
实测失败率 0.9%(8 个会话 11283 次调用里 104 次),所以红标是有效信号,
不至于把面板染红。⚠️ 但别拿它当"退出码非零":bash 的非零退出不算失败
(退出码是结果数据,只在正文尾部标 [exit code: N])。
这个插件读你的会话,所以边界写清楚:
| 会写盘的东西 | 标题缓存 ~/.dsh/think-flow/titles.json 与译文缓存 ~/.dsh/think-flow/translations.json,都是可重建的派生数据,分别受 maxTitledTurns / maxTranslationEntries 限制。缓存损坏时按空缓存处理;标题缓存直接写入,译文缓存通过临时文件替换 |
| 会话数据 | 只读。会话日志由宿主写,插件只读不写;内存里折出来的轨迹按 LRU 回收 |
| 什么时候联网 | 「生成标题」/「实时」会通过宿主 llm 调用模型;启用中文机翻时,需要翻译的原文段落会通过宿主 translator 发往所选 Bing/Google 翻译端点。关闭机翻或命中译文缓存时不发起翻译请求 |
| 遥测 | 没有。不上报任何东西 |
/ping、/sessions | 只报计数与 build 号,不含会话内容 |
开发仓库里另有一层约定:真实会话渲染出来的开发资料不进公开仓库、也不进 npm 包
(.gitignore / .npmignore 里单列一段),公开的预览页与截图一律用
scripts/preview/demo-data.mjs 里合成的数据。
npm ci                     # 按 package-lock.json 安装项目依赖;开发验证使用 Node 22.14 / 24

npm run build              # 项目内 tsc 编译宿主 + esbuild 打包客户端 → lib/
npm test                   # 自动构建当前源码,再跑模板检查、行为测试和构建回归检查
npm run preview            # 生成 docs/ui-preview.html(真组件 + 真主题 token,合成数据)
npm run shots              # 重新生成 assets/*.png(README 那几张图)
npm run align              # 布局对齐检查(需先 preview,并安装 Chrome 或设置 DSH_CHROME)
完整测试及下面的领域测试命令都会先构建当前源码,不会读取过期的 lib/。构建使用项目锁定的 TypeScript 与 esbuild;不再扫描全局编译器或本机 npx 缓存。主题预览默认使用项目依赖,也可显式设置 DSH_CHECKOUT 选择另一份宿主主题。
单独跑某一套:
npm run test:trace     # 纯函数折叠(含工具失败、截断、步边界)
npm run test:titles    # 提示词预算、响应解析容错、缓存指纹
npm run test:routes    # SSE 分帧、快照形状、按需取原文、LRU、节流、心跳、缓存
npm run test:client    # 注册、渲染、交互、历史、目录、对比度(解析真 token 算)
npm run test:translate # 译文缓存与持久化
npm run test:build     # 测试自动重建、类型错误中止、发布包边界
| 路径 | |
|---|---|
src/index.ts | 宿主入口:组装服务、订阅事件 |
src/host/ | 会话与历史恢复、标题/翻译服务、快照、HTTP/SSE、配置与内部类型 |
src/trace.ts | 折叠逻辑(纯函数,可单测) |
src/titles.ts | 标题提示词、预算、响应解析、内容指纹 |
src/client/index.js | 客户端 ModuleLoader 注册与服务组装入口 |
src/client/panel.js、components/ | 面板交互、步骤展示和历史目录 |
src/client/rules/ | 工具与命令派生标题、阶段分组、格式化规则 |
src/client/translation.js、host-navigation.js、view-state.js | 翻译队列、宿主页面适配、视图状态 |
src/client/styles.css、styles.js | 宿主 token 样式及注入/卸载生命周期 |
tests/ | 领域逻辑、路由、客户端与构建回归测试 |
scripts/preview/demo-data.mjs | 合成演示会话(预览页与截图共用) |
scripts/preview/demo-scenes.mjs | 演示场景定义(预览页与截图共用同一份,图不会和实物不一致) |
scripts/preview/preview-harness.mjs | 跑构建产物里真组件的底座 + 宿主主题 token 提取 |
scripts/preview/gen-readme-shots.mjs | 出 README 截图(headless Chrome,2× 出图) |
持续检查在普通 push / PR 时执行;发布流程使用同一份锁文件。npm pack / npm publish 会自动构建,发布包只包含运行时、类型、源码与必要元信息,开发工具与本地资料留在仓库。
怎么确认改动生效了:curl -s localhost:3080/think-flow/api/ping 看 build 号 ——
改宿主代码后 +1。host 半要重启 dsh web(热重载只重建 fiber,不重新 import 模块,
ESM 缓存里还是旧代码);client 半刷新页面即可。
maxHydrateEvents 条事件:上万事件的长会话,更早的轮次可能折不完整。loadThrough 翻到位、精确落位(离顶 24px)。窄窗口下刻度轨道
(容器查询)不渲染时,退回到"插件自己翻历史再滚"。session.loadThrough(seq) 把历史翻到
这一轮,再在一个虚拟滚动的表格里滚动找那一行(屏幕外的行根本不在 DOM 里,行高也不齐,
算不出偏移,只能"读着渲染出来的轮次边界走"),最后点它一下把"选中"交给宿主
(选中态是宿主的:data-selected + 轮次标签高亮 + 检查器,都由它自己画)。
长会话里这一路可能翻不动或找不到 —— 那时按上限安静放弃(不做任何事,也不会把
表格搅乱);重试一次或先把轨迹滚到顶通常就有了。压缩过的会话里记录顺序可能乱
(见"边界与已知限制"),那时二分走不动,会自动退回按位置从头扫一遍。步骤是"一次模型往返",只有轨迹页把它当
一条记录摆出来、并且给了可寻址的身份。对话页那边每一步都躺在折叠住的过程块里,
没有能定位的锚点 —— 硬做只能在界面上凭空找位置,不如老实不做(对话页里点 #N 是空操作)。
轨迹页里长轮次也一样能到:先按轮定位(翻历史 + 滚),再按 (轮, 步) 路标一跳一屏地往里走。3,4,1,5,6(第 6 轮的行排在第 5、7 轮后面),有的轮次还会整段缺失 ——
那是宿主的记录模型(dsh-client-ui-trajectory),插件改不了。插件的对策是不假设顺序:
目标行按行身份(assistant\0轮\0步)认,二分走不动时兜底从头按位置扫一遍。
但模型里根本没有的行,谁也变不出来 —— 那种情况按上限安静放弃。ctx.effect 上,卸载即清):标题节拍(autoTickMs)、
冷轮按时间收回(coldTtlMs/10,封顶 5 分钟)、过期自愈扫描(resyncSilenceMs,封顶 10 秒)。
内存有容量上限(LRU + 冷轮预算);标题缓存文件坏掉会静默重置。MIT © 2026 yfwu2020
DeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
把回答做成一页可视化 HTML:模型只写简短的 Markdown 草稿,随包附带的 `am` 命令行生成页面,支持流程图、时序图、树、时间线、ER 图、表格和提示框。
在 dsh 里装上这个插件即可,无需登录、注册或填 API Key,就能使用包括 Muse Spark 1.3、MiMo V2.6 在内的前沿模型——完全免费,不限量。 All you do is install this plugin in dsh: no login, no sign-up, no API key — the frontier models are just there, Muse Spark 1.3 and MiMo V2.6 among them. Completely free, with no usage cap.

