ppy-web/dsh-plugin-xiaomi-mimo-tts
ppy-web/dsh-plugin-xiaomi-mimo-tts为 DSH 提供小米 MiMo、豆包、浏览器本地 TTS 语音朗读;自动播报、自定义音色、UI 音效、桌宠联动、QQBot 联动。

把本机 GPT-SoVITS 音色接进 DSH:voice_speak 工具与 /voice 命令朗读,每条助手回复下方有喇叭按钮,设置页可切音色、调合成参数、管本地推理服务,并支持一键安装音色包。仅 Windows;需本机已有 GPT-SoVITS 仓库、训练好的权重与它的 Python 环境。
把你的 GPT-SoVITS 音色接进 DSH(DeepSeek Harness):
voice_speak / voice_settings 两个工具,以及输入框里的 /voice 命令,给智能体和你自己都能用。api_v2.py)跑在 127.0.0.1,音频不出机器。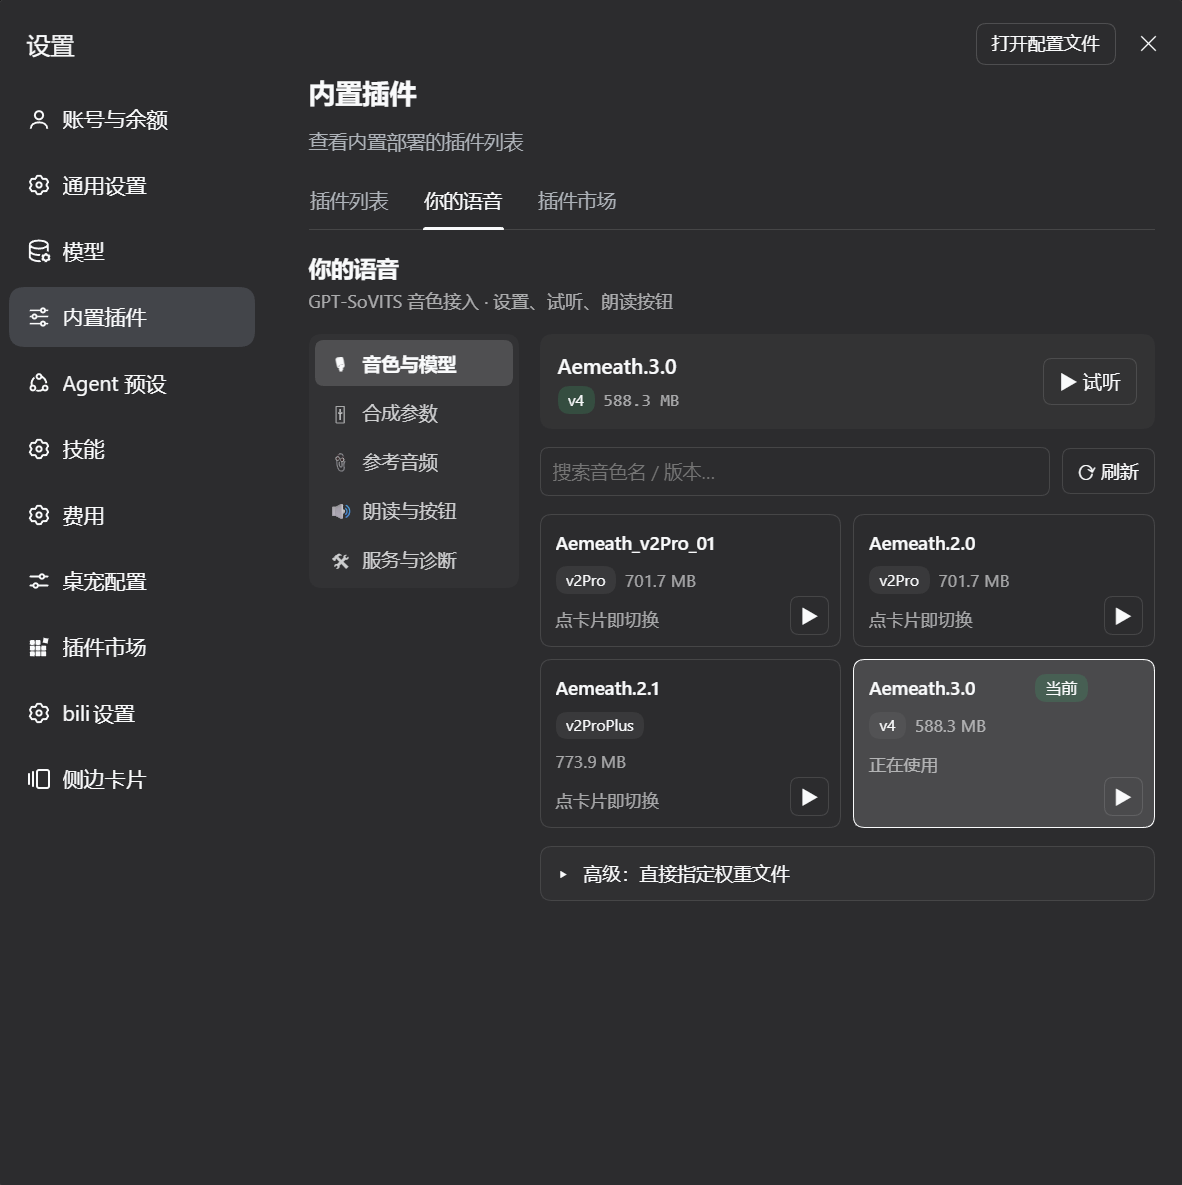
| 回复下方的喇叭(待机 / 播放中,再点一次停) | 朗读与按钮 |
|---|---|
  |  |
| 依赖 | 说明 |
|---|---|
| DSH | Web / Desktop 均可,插件装进 profile(默认 web) |
| Node.js | ≥ 20(用 DSH 自带的运行时也行) |
| GPT-SoVITS | 本机的 GPT-SoVITS 仓库(含 api_v2.py)+ 它自己的 Python 环境 |
| 训练好的权重 | GPT_weights_v4/*.ckpt + SoVITS_weights_v4/*.pth(版本按你的模型 v1/v2/v3/v4 对应) |
| 参考音频 | ref/ 目录里一段 3~10 秒干净人声 + 逐字一致的文本 |
插件本身不训练模型:训练在 GPT-SoVITS 那边做完,这里负责「切换、调参、试听、朗读」。
dsh plugin --profile web add dsh-yourself-voice
在 DSH 的 profile 补丁(~/.dsh/profiles/<profile>/cordis.patch.yml)里加一条:
- insert:
    - id: yourself-voice
      name: "file:///绝对路径/plugin/index.mjs?v=1"
      config:
        dataDir: "绝对路径/你的数据目录"
config.dataDir 省略时默认 ~/.dsh/yourself-voice。改完重启 DSH(或用下面的 ?v=N 热重载)。
用
dsh plugin add装的话,profile 里的node_modules/dsh-yourself-voice会指向这个包, 入口名写包名即可;本仓库的install/install.ps1是等价的手工安装脚本。
api_v2.py)。ref/ 里的音频,确认「参考文本」与音频逐字一致(同名的 .txt 会被自动填进来)。第一次朗读会拉起推理服务,冷启动大约 1 分钟(看显卡和模型大小),之后常驻、单条合成通常 3~8 秒。
| tab | 内容 |
|---|---|
| 音色与模型 | 当前音色、搜索、卡片列表(点卡片切换、▶ 试听)、高级:模型架构 / GPT 权重 / SoVITS 权重 / 模型目录、最近试听(可重播、可清空) |
| 合成参数 | 预设下拉(应用 / 另存为 / 删除)+ 语速、合成语言在明面上,温度、top-k、top-p、随机种子、切句方式收在「高级参数」折叠区;每项都能单项「恢复默认」 |
| 参考音频 | 参考音频卡片、参考文本多行框、参考文本语言,可试听参考音频本身 |
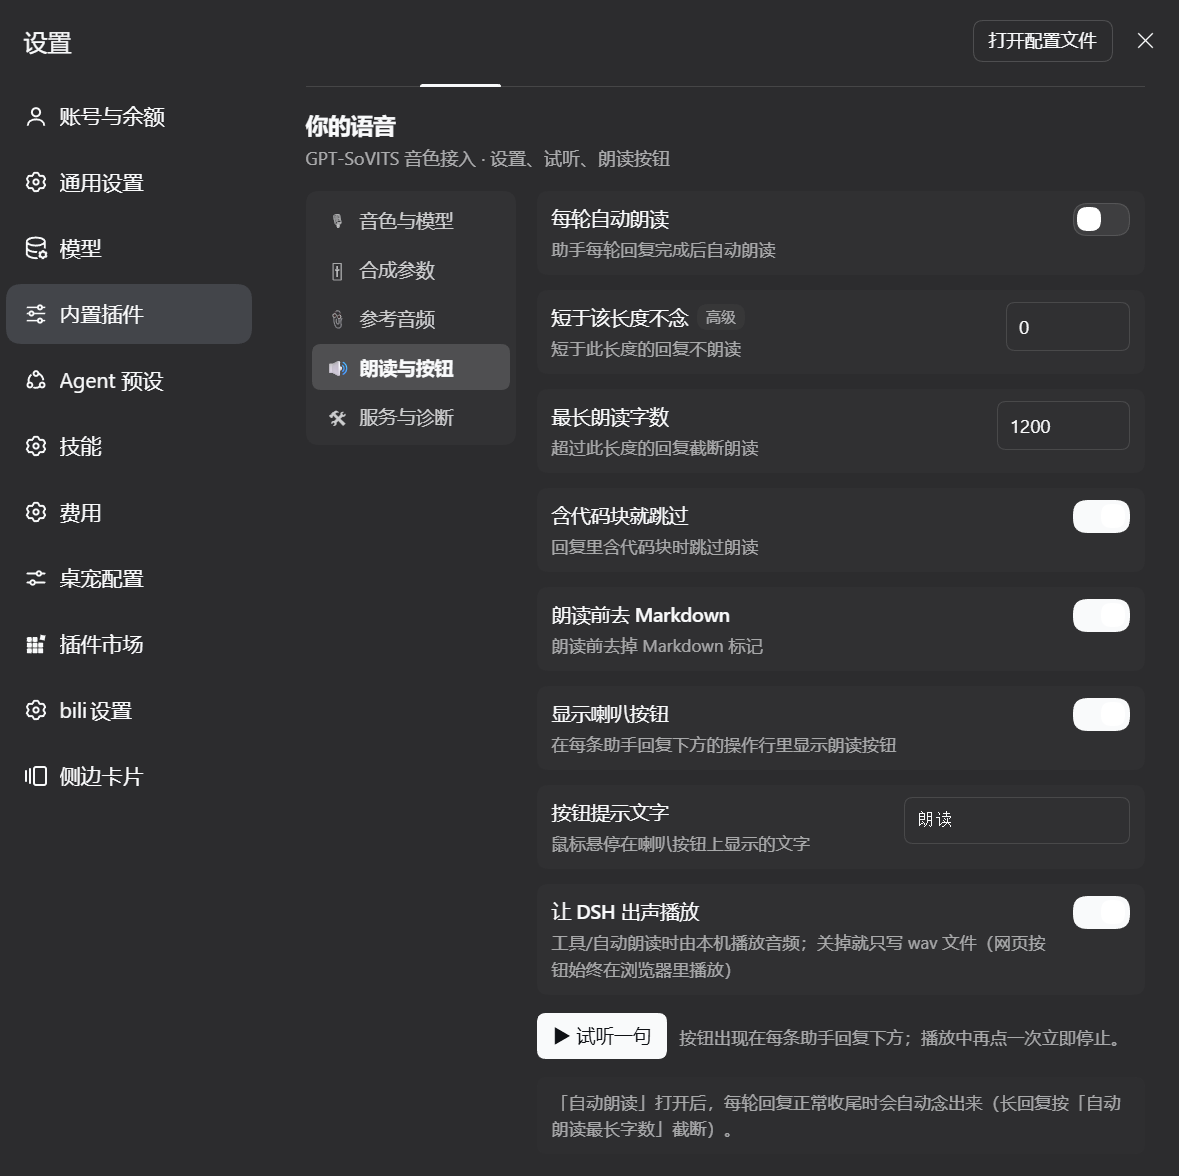
| 朗读与按钮 | 显示喇叭按钮、按钮提示文字、每轮自动朗读、最短/最长朗读字数、含代码块跳过、朗读前去 Markdown、让 DSH 出声播放 |
| 服务与诊断 | 服务状态、地址、设备、参考音频就绪检查、启动/停止/重启、服务日志、复制诊断信息 |
| 音色包 | 别人训练好的整套音色(权重 + 参考音频 + 参考原文),点「下载安装」一键装好并自动切过去;也能装本地 .tar.gz |
改动即时保存:普通输入失焦/防抖 300ms 写盘;下拉、开关、点卡片立刻生效。 涉及模型架构 / 设备 / 端口 / 模型目录的改动会重启推理服务(界面会提示)。
主包故意不带权重(一个音色动辄 200 MB,塞进 npm 包每次升级都要重下)。权重走「音色包」:一个 .tar.gz,里面是 manifest.json + GPT 权重 + SoVITS 权重 + 参考音频 + 参考原文。
装的人只需要 设置 → 插件 → 你的语音 → 音色包 → 下载安装(也可以「选本地 .tar.gz」装别人传给你的文件)。装完会自动切到新音色、重启一次推理服务;同一份包重复装会识别出「文件都在、大小一致」,不重写、不重启。
<数据目录>/voicepack/installed.json,界面据此显示「已安装 / 更新可装」。# 在 plugin/ 目录,Node 用 DSH 自带的那份即可
node scripts/build-voicepack.mjs --write
# 产出 dist/aemeath3-1.0.0.tar.gz,并把 size / sha256 / 文件清单写回 voicepacks.json
常用参数:--id、--label、--version、--out、--url、--gpt、--sovits、--ref、--prompt、--data-dir。
默认取 settings.json 里当前正在用的那套音色,所以「我现在听的这个」就是被打包的那个。
一条命令搞定(本机没有 Node 也能跑,只要系统自带 curl.exe):
.\release-voicepack.cmd -Repo <你的GitHub用户名>/dsh-yourself-voice -Token <GitHub token>
它会核对包的 size/sha256 → 建/复用 Release(tag voicepack-<id>-<version>)→ 流式上传 203 MB → 回读核对 → 只改 voicepacks.json 里 url 那一行。仓库不存在时加 -CreateRepo 自动建(必须 public,否则别人下不到附件);-DryRun 只核对不上传。
想手传也行:把 dist/*.tar.gz 传到 GitHub Releases(或任意直链对象存储),把地址写进 voicepacks.json 的 url(size、sha256、files 由 build-voicepack.mjs 填好),再发 npm 包。
界面会给 size 做进度条、装之前核对整包 sha256;url 空着时按钮是灰的,并提示发布者还没配地址。
dist/不进 npm 包(见.gitignore与files白名单),发布前记得单独上传。音色包里的权重能不能再分发,取决于训练者授权——自己训练的才 freely 分发。
voice_speak   { text, play?, speed?, textLang?, maxChars?, raw? }
voice_settings{ action: show|help|status|models|voices|set|preset|applyVoice|preview|reload|start|stop|restartServer, changes? }

/voice on | off | say <文本> | last | speed <n> | lang <代码> | voices | use <音色名> | button on|off
浏览器半边只跟这些路由说话(前缀 /yourself-voice,仅接受本机同源请求):
| 方法 | 路径 | 作用 |
|---|---|---|
| GET | /ping | 探活 + 服务状态 + 按钮配置 |
| GET/POST | /settings | 读设置 / 改设置({changes, presets?, restart?}) |
| POST | /settings/reset | 恢复默认(可只传 {keys:[...]}) |
| GET | /models | 音色卡片、权重文件、参考音频列表 |
| POST | /models/apply | 切换音色 / 权重 / 参考音频({voiceId} 或 {gptWeights,...}) |
| GET/POST | /engine | 状态 / {action: start|stop|restart} |
| GET | /log?lines=160 | 服务日志尾部 |
| POST | /preview | 试听:{text, overrides?} → wav 字节,并记进历史 |
| GET/POST | /history | 最近试听列表 / {action:'clear'|'delete', id?} |
| GET | /audio?id= | 回放某条试听 |
| GET | /ref-audio?file= | 回放参考音频(只允许 ref/ 里的文件) |
| POST | /speak | 助手回复正文 → wav({sessionId, messageId, text?, dry?}) |
| GET | /voicepack | 音色包清单(含安装状态)+ 当前安装进度 |
| GET | /voicepack/status | 只取安装进度 |
| POST | /voicepack/install | 按清单里的 id(或直接给 url)下载并安装,202 后轮询进度 |
| POST | /voicepack/install-file | 装本地 .tar.gz({path}) |
| POST | /voicepack/cancel | 取消正在进行的安装 |
| GET | /messages | 诊断:会话里带正文的助手消息 |
| GET | /debug | 诊断:客户端模块图、引擎状态、装配问题 |
plugin/                  ← npm 包(要发布的就这个目录)
  index.mjs              宿主半边门面:工具、命令、自动朗读、路由装配
  api.mjs                全部 HTTP 路由(设置 / 模型 / 试听 / 朗读)
  settings.mjs           设置读写、默认值、校验、字段元数据、生成 tts_config.yaml
  models.mjs             扫权重目录、配「音色」、扫参考音频
  engine.mjs             拉起推理服务、POST /tts、本机播放
  text.mjs               Markdown → 口语文本
  voicepack.mjs          音色包:下载 / 解包 / 逐文件校验 / 落地 / 记账
  voicepacks.json        音色包清单(id、label、version、size、sha256、url)
  scripts/               build-voicepack.mjs:把当前音色打成 .tar.gz 并回填清单
  client.js              浏览器半边(手写 bundle):设置页 + 喇叭按钮
  tool.mjs               defineTool 的本地等价实现(官方包不在插件解析范围内)
  assets/                首次运行铺进数据目录的模板(start_server.ps1 / speak.ps1 / ref 说明)
  test/                  自测脚本(宿主接口 / 浏览器半边 / 音色包 / 引擎,见下)
  cordis.patch.yml       npm 装载用的补丁片段
数据目录(默认 ~/.dsh/yourself-voice):
settings.json            设置
tts_config.yaml          按设置生成,给 api_v2.py 用
ref/                     参考音频 + 文本
out/                     最近输出、服务日志、试听历史(out/previews/)
start_server.ps1         拉起推理服务(从 assets/ 铺开)
喇叭点了没反应 / 一直是「合成中…」
看 服务与诊断 → 看服务日志;/yourself-voice/debug 也能看到引擎状态与装配问题。
冷启动第一次要等约 1 分钟。
切了模型没生效 GPT-SoVITS 的模型架构(v1/v2/v3/v4)必须和权重所在目录对应,放错目录就会加载失败。 设置页「音色与模型 → 高级」里的「模型架构」要和权重目录一致;换架构会重启服务。
报「参考音频不存在」/ 读出来不像
ref/ 里的音频要 3~10 秒、干净、无伴奏;「参考文本」必须和音频逐字一致(差一个字都会跑调)。
端口被占用
默认 127.0.0.1:9880,和别的 GPT-SoVITS 实例撞了就在「服务与诊断」里改端口(会重启)。
音色包下载慢 / 卡在某个百分比
进度条走的是 content-length,断流会一直停在原地——点「取消」再来一次即可(已下完的部分用临时文件,重试从 0 开始)。
加速:把 .tar.gz 放本机/局域网,用「选本地 .tar.gz」装,跳过下载。
音色包装完,念出来还是原来那个声音
看「服务与诊断 → 服务状态」:装完会自动切音色并重启一次,重启要十几秒到一分钟;重启失败时界面会在音色包 tab 下面写原因(已装好,但自动切换音色失败:…),到「音色与模型」手动点一下新卡片就行。
装完看不到设置页
profile 补丁里的 id / 入口名要对应;用 dsh plugin list --profile web 确认插件是 active,
再刷新页面。宿主代码改了按下面的热重载走一遍。
浏览器半边(client.js)和宿主半边(*.mjs)都可以热重载:
plugin/*.mjs 或 plugin/client.js;?v=N 加一(例如 index.mjs?v=3 → ?v=4);?v= 也加一(./api.mjs?v=3 → ./api.mjs?v=4,涉及的
文件:index.mjs、api.mjs、engine.mjs、text.mjs……)。漏掉这一步会出现
The requested module './settings.mjs' does not provide an export named '…' 这类怪错:
入口被重新 import 了,但它 import 的依赖还是缓存里的旧模块(相对 import 解析出的 URL 不带
query,命中旧缓存)。工作区里有个小工具可以直接批量改:
.scratch\bump-plugin-imports.mjs <N>;yourself-voice 关一次、开一次(GUI 里点,或 plugin_manager set_plugin);out/plugin-module-loaded.json 里的 url 变成新的 ?v=N,且curl http://127.0.0.1:19387/yourself-voice/ping
为什么要这样:Node 的 ESM 模块缓存按 URL 字符串命中,?v=N 变了才会真正重新 import;
浏览器帮手的 bundle 也是在插件激活时快照的,同样需要重新扫描一次。
npm install                 # 装 devDependencies(jsdom / react / react-dom)
npm test                    # = test:voicepack + test:api + test:ui
npm run test:voicepack      # 只跑音色包(不用开 DSH、不联网)
npm run test:engine         # 只看引擎(不用开 DSH)
这台开发机上没有装 Node.js,所以上面几行要走插件目录里的发布脚本(它用 DSH 自带的 node+pnpm):
.\publish.cmd -DryRun(= 自测 + 打包干跑 + 发布干跑)。装上 Node.js 之后npm test一样能用。
| 脚本 | 它验证什么 |
|---|---|
test/voicepack.mjs | 音色包全链路(纯模块、不依赖 DSH):做一个小包 → HTTP 下载(含 302 重定向)→ 逐文件 sha256 校验 → 落地 → 记账 → 重复装识别为「一个都不重写」;被篡改的包整包拒收且不落地;不是音色包的文件被拒;--data-dir 里就地装本地包;装完 scanLibrary 能扫出新音色。 |
test/api.mjs | 宿主全部 HTTP 接口:设置读写与校验(超范围/未知键会被拒、磁盘不被写坏)、预设往返、模型扫描、参考音频与路径穿越防护、日志/引擎状态、会话正文 → /speak 干跑与 404、试听合成 → 历史回放 → 删除、音色包路由(清单/进度/不存在的 id 或文件/空闲取消)、信任围栏(sec-fetch-site/跨源 Origin/伪造 Host 都 403)。连不上 DSH 时自动跳过。 |
test/ui.mjs | 浏览器半边:按加载器的方式执行 client.js,确认注册了两个槽位、六个 tab 都能渲染、卡片与试听按钮齐、没有 <button> 嵌 <button> 这种非法结构;连不上 DSH 时退回内置样例数据,组件照样被渲染点击。 |
test/engine.mjs | 引擎本身:设置读取、生成 tts_config.yaml、拉起服务、合成一段 wav(--text 只看 Markdown → 口语转换,--play 顺便播出来)。 |
test/api.mjs 会真的合成一次(几秒),并且跑完把 settings.json 按字节还原。指定目标:
node test/api.mjs --host http://127.0.0.1:8080 --data-dir "C:\\...\\aemeath-voice"
node test/ui.mjs --host http://127.0.0.1:8080
这个包按市场要求准备好了(dsh.manifestVersion / dsh.client / dsh.compatibility / engines /
files 白名单 / 中英 README / MIT 许可证 / 截图目录),发布步骤、精选列表
awesome-dsh-plugin 的 PR 条目模板、
以及上架前 checklist 都在 PUBLISH.md。
dsh-yourself-voice brings your locally trained GPT-SoVITS voice into DSH:
voice_speak / voice_settings tools and the /voice command for agents and humans alike;.tar.gz bundles (weights + reference clip + transcript) installed with one click from the settings page, sha256-verified per file, auto-switched after install;127.0.0.1, audio never leaves the machine.Requirements: DSH, Node ≥ 20, a local GPT-SoVITS checkout (api_v2.py), trained weights, and a 3–10 s clean reference clip with its exact transcript.
Install: dsh plugin --profile web add dsh-yourself-voice, then set the GPT-SoVITS root in the settings tab.
MIT licensed.
MIT,见 LICENSE。
为 DSH 提供小米 MiMo、豆包、浏览器本地 TTS 语音朗读;自动播报、自定义音色、UI 音效、桌宠联动、QQBot 联动。
面向 DeepSeek Harness (dsh) 的语音输入插件:输入框的麦克风按钮把语音转成草稿文本,支持多种语音识别后端,可选经 dsh 自有 LLM 路由润色,并带原生设置页。
零外部依赖、事件驱动、无需额外模型、不消耗任何 token的语音播报插件。使用系统自带自然语音进行播报,支持win/mac双平台;最终回复、审批与提问提醒、可选事件播报(回合结束/命令完成/目标变更/工具出错/待办更新)、最终回复可重播、双语言可视化设置。