
dsh-web
zhu1090093659/dsh-webDeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)

为DSH接入本地大模型能力:在「设置→插件」页一键启停本地 llama.cpp 大模型(双槽x双模态x双预设),卡片内配置、一条命令安装、自动注册,装完即用| Enable local large model capabilities for DSH: One-click start/stop for local llama.cpp models (dual‑slot × dual‑modal × dual‑preset) right in Settings → Plugins; configure within the card, install with a single command, automatically register, and ready to use
DSH 插件:在设置页一键启停本地 llama.cpp 服务,使本地大模型成为 DSH 会话模型
配置卡片位于 设置 → 插件 → 本地大模型控制器
English | 简体中文
兼容性说明:DSH 0.1.7-rc.1 进行了大规模底层重构,本插件自 v2.1.0 起适配该架构(仅适配 RC 分支,其余分支不作保证)。
本插件仅承担 DSH 与 llama.cpp 之间的连接与控制:不包含 llama-server 本体,也不负责模型下载。二者分别来自上游 llama.cpp 与社区量化发布(如 Hugging Face)。
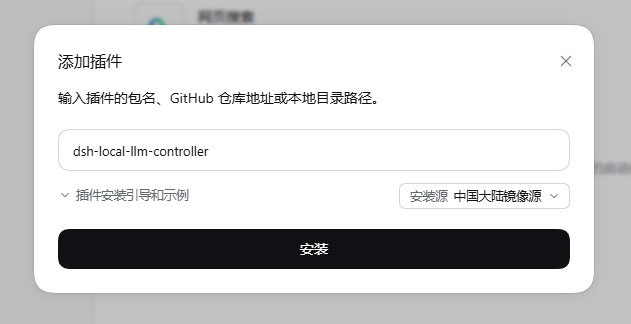
推荐通过 DSH 内置插件管理器安装:侧边栏 设置 → 插件 → 添加插件,输入下表任意一种地址,选择安装源后安装并启用。安装完成后无需重启 DSH Web。
也可使用命令行安装(重复执行同一命令即为升级;已是最新版本时提示 Already up to date):
dsh plugin --profile web add <地址>
| 地址形式 | 说明 |
|---|---|
| dsh-local-llm-controller | 包名,从 npm registry 安装最新发布版 |
| 本地文件夹路径 | link 活链,开发调试首选,拉取更新后重启 DSH 生效 |
| releases tgz 包路径 | 离线安装发布包 |
| GitHub 仓库地址 | 安装远程最新推送,可能不稳定 |
常用命令:
dsh plugin --profile web outdated                                       # 检查更新,无输出即已是最新
dsh plugin --profile web add dsh-local-llm-controller@2.1.3             # 安装指定版本
npx @deepseek-ai/dsh plugin --profile web add dsh-local-llm-controller  # 未全局安装 dsh CLI 时的等价调用
[!NOTE] 安装或升级时出现 peer 依赖警告属正常现象:本插件的 peer 依赖由 DSH 宿主提供,不随包安装,不影响使用。
| 写入条目 | 取值 |
|---|---|
| contextWindow | 槽位快速参数组的 -c 值 |
| maxTokens | 上述 -c 值的四分之一(v2.1.2 起由二分之一下调:预留过大会压低压缩阈值,见「本地压缩引擎」) |
dsh plugin --profile web remove dsh-local-llm-controller
卸载命令会自动清理 profile 的 bundle 注册与依赖声明,以下内容不会被自动删除(v2.1.0 / DSH 0.1.7-rc.1 实测):
| 残留项(可选清理) | 说明 |
|---|---|
| ~/.dsh/local-llm.config.json | 卡片配置(llama.cpp 目录、端口与八组启动参数)。计划重装则保留 |
| profile 补丁中的 llm-pi-ai.providers.dsh-local | 「添加到模型列表」写入的模型页条目;手动运行同端口服务时仍可用,不用则删 |
| pnpm-workspace.yaml 的版本豁免行 | 卸载不回收的安装元数据,无害 |
[!NOTE] 从 v2.0.x 升级:旧版 settings.yaml 中的 local-llm 配置段已随 DSH 0.1.7 的一次性导入更名为 settings.yaml.imported,无程序读取,无需处理。
12G VRAM + 32G RAM
35B(Occamy-1.0,MoE,IQ4_NL)
文本
35B · 文本 · 快速    : -ngl 99 -fa on -np 1 --cache-type-k q8_0 --cache-type-v q8_0 -cmoe --moe-cache-mib 8608 --load-mode none --reasoning-budget 8192 --cache-ram 2048 --ctx-checkpoints 8 --temp 0.6 --top-k 20 --top-p 0.95 --min-p 0.0 --repeat-penalty 1 --presence-penalty 0 -c 32768 --metrics --slots
35B · 文本 · 长上下文 : -ngl 99 -fa on -np 1 --cache-type-k q8_0 --cache-type-v q8_0 -cmoe --moe-cache-mib 7600 --load-mode none --reasoning-budget 8192 --cache-ram 4096 --ctx-checkpoints 8 --temp 0.6 --top-k 20 --top-p 0.95 --min-p 0.0 --repeat-penalty 1 --presence-penalty 0 -c 131072 --metrics --slots
视觉
35B · 视觉 · 快速    : -ngl 99 -mmdev none -fa on -np 1 --cache-type-k q8_0 --cache-type-v q8_0 -cmoe --moe-cache-mib 8608 --load-mode none --reasoning-budget 8192 --cache-ram 2048 --ctx-checkpoints 8 --temp 0.6 --top-k 20 --top-p 0.95 --min-p 0.0 --repeat-penalty 1 --presence-penalty 0 -c 32768 --metrics --slots
35B · 视觉 · 长上下文 : -ngl 99 -mmdev none -fa on -np 1 --cache-type-k q8_0 --cache-type-v q8_0 -cmoe --moe-cache-mib 7600 --load-mode none --reasoning-budget 8192 --cache-ram 4096 --ctx-checkpoints 8 --temp 0.6 --top-k 20 --top-p 0.95 --min-p 0.0 --repeat-penalty 1 --presence-penalty 0 -c 131072 --metrics --slots
9B(Qwen3.5-9B,Dense,Q4_K_M)
文本
9B · 文本 · 快速    : -ngl 99 -fa auto -np 1 --cache-type-k q8_0 --cache-type-v q8_0 --reasoning-budget 8192 --cache-ram 4096 --ctx-checkpoints 8 --temp 0.8 --top-k 40 --top-p 0.95 --min-p 0.05 --repeat-penalty 1 --presence-penalty 0 -c 32768 --metrics --slots
9B · 文本 · 长上下文 : -ngl 99 -fa auto -np 1 --cache-type-k q8_0 --cache-type-v q8_0 --reasoning-budget 8192 --cache-ram 4096 --ctx-checkpoints 8 --temp 0.8 --top-k 40 --top-p 0.95 --min-p 0.05 --repeat-penalty 1 --presence-penalty 0 -c 65536 --metrics --slots
视觉
9B · 视觉 · 快速    : -ngl 99 -mmdev none -fa auto -np 1 --cache-type-k q8_0 --cache-type-v q8_0 --reasoning-budget 8192 --cache-ram 4096 --ctx-checkpoints 8 --temp 0.8 --top-k 40 --top-p 0.95 --min-p 0.05 --repeat-penalty 1 --presence-penalty 0 -c 32768 --metrics --slots
9B · 视觉 · 长上下文 : -ngl 99 -mmdev none -fa auto -np 1 --cache-type-k q8_0 --cache-type-v q8_0 --reasoning-budget 8192 --cache-ram 4096 --ctx-checkpoints 8 --temp 0.8 --top-k 40 --top-p 0.95 --min-p 0.05 --repeat-penalty 1 --presence-penalty 0 -c 65536 --metrics --slots
更完整的实测数据、选型结论与实验方法见「推荐阅读」。
-ncmoe 方案):含视觉预设实测;-cmoe 方案与 -ncmoe 方案的同显存三档对照见 08-occamy-cmoe.md。本插件以子路径导出形式提供压缩引擎 LocalCompactionEngine,继承官方 CompactionEngine 基类,用于替换 DSH 内置压缩引擎。面向 32k~256k 本地上下文窗口,解决内置引擎的两类问题:触发阈值被固定预留量压低乃至静默停用;压缩后占用仍然偏高,下一轮再次触发压缩形成正反馈。
| 项 | 说明 |
|---|---|
| 引擎入口 | 子路径导出 dsh-local-llm-controller/compaction |
| 导出类 | LocalCompactionEngine,继承 @deepseek-ai/dsh-compaction 的 CompactionEngine |
| 替换对象 | @deepseek-ai/dsh-compaction-basic(DSH 内置压缩引擎) |
| 运行时注册 | 引擎注册为 ctx.compaction,手动 /compact 命令自动兼容 |
| 宿主依赖 | @deepseek-ai/dsh-* 以 >=0.1.7-rc.1 声明,由 DSH 宿主提供,DSH 升级无需修改版本号 |
| 维度 | DSH 默认(dsh-compaction-basic) | 本引擎 |
|---|---|---|
| 触发阈值 | min(0.8W, W − maxTokens − 65536),预留量为固定常数 | min(0.7W, W − reserved − margin),随窗口比例缩放 |
| 小窗口表现 | 32768 窗口公式为负,自动压缩静默停用;131072 窗口阈值降至 37.5%,频繁提前压缩 | 32768 窗口阈值 22937、131072 窗口阈值 91750,均约 70% |
| 二次触发 | 摘要与保留尾部之和可能高于阈值,下一轮再次压缩 | 尾部封顶构造保证压缩后占用远低于阈值,从构造上消除正反馈 |
| 摘要调用 | 固定 65536 token 预算 | 三级降级(见下),输出预算按剩余空间动态推导 |
| 工具结果修剪 | 可选 | 压缩前强制执行,修剪后占用达标即跳过 LLM 摘要 |
| 适用场景 | 百万级云端窗口 | 32k~256k 本地窗口 |
| 机制 | 说明 |
|---|---|
| 比例阈值 | threshold = min(0.7W, W − reserved − margin),margin = clamp(0.05W, 1024, 8192) |
| 尾部封顶 | tail ≤ min(0.16 × (W − reserved), threshold − summaryUpper − margin) |
| 摘要降级 | 本地路由模型摘要(复用 KV 前缀缓存,自动重试,默认共 2 次尝试)→ 云端摘要目标(可选)→ 截断式检查点兜底(确定性构造,不依赖模型,会话不卡死) |
| 前置修剪 | 压缩前先修剪旧工具结果,修剪后占用低于阈值则完全跳过 LLM 摘要 |
| 溢出恢复 | 请求窗口溢出时自动恢复,手动压缩路径兼容 |
| 运行日志 | 全程携带 [local-compaction] 前缀,覆盖压力检查、压缩提交、摘要降级、溢出恢复 |
本引擎无法在安装后自动替换官方预设内置的压缩组:官方补丁机制的寻址范围不覆盖预设内部的插件列表。使用方式为在 DSH 中创建自定义 agent 模式(预设),并在其插件列表中声明压缩组:
- id: compaction
  name: cordis:group
  group: true
  isolate:
    compaction: true
    toolResultPruner: true
  config:
    - id: local-compaction
      name: 'dsh-local-llm-controller/compaction'
    - id: command-compact
      name: '@deepseek-ai/dsh-command-compact'
    - id: tool-result-pruner
      name: '@deepseek-ai/dsh-compaction-tool-result-pruner'
      config:
        thresholdChars: 4096
        headChars: 2048
        tailChars: 512
isolate 字段必须保留:引擎通过 ctx.get 读取工具结果修剪器,两者需处于同一 isolate realm。
预设可通过用户层补丁文件声明(以 link 依赖注册进 profile 并列入 dsh.profile.bundles),也可通过 Web 设置编辑器创建。回落与停用:将压缩子行的 name 改回 @deepseek-ai/dsh-compaction-basic 即恢复官方引擎;修改后需重启 DSH 生效(bundle 补丁文件不参与热重载)。
引擎子行的可选配置:
| 配置键 | 说明 |
|---|---|
| thresholdRatio / retainRatio / summaryReserveTokens | 阈值与预留相关参数 |
| summarizationProvider / summarizationModel | 成对配置的云端摘要目标 |
| compactionRetries / maxOverflowRetries | 压缩与溢出恢复的重试次数 |
| auto | 自动压缩开关 |
| 预设档 | 窗口 | 行为 |
|---|---|---|
| fast | 32768 | 受控实测:占用 13116 tokens 压缩至 7103,此后稳定运行,无二次触发 |
| long | 131072 | 真实会话:93313、91924、93973 三次越线均由工具结果修剪单独化解(最低降至 69189),未调用 LLM 摘要;93290 再次越线后触发压缩,本地模型摘要约 1817 tokens,占用降至 44479,此后低位稳定运行 |
DeepSeek Harness(DSH)Web 插件聚合生态包 · 一切皆插件,创意工坊分发(dsh-market.com)
把回答做成一页可视化 HTML:模型只写简短的 Markdown 草稿,随包附带的 `am` 命令行生成页面,支持流程图、时序图、树、时间线、ER 图、表格和提示框。
在 dsh 里装上这个插件即可,无需登录、注册或填 API Key,就能使用包括 Muse Spark 1.3、MiMo V2.6 在内的前沿模型——完全免费,不限量。 All you do is install this plugin in dsh: no login, no sign-up, no API key — the frontier models are just there, Muse Spark 1.3 and MiMo V2.6 among them. Completely free, with no usage cap.

